06 juin 2014

Windows Sucks

Un problème récurrent que les clients CloudBees reportent au support est l'utilisation de machines de build Windows. Nous recommandons clairement d'utiliser un Linux pour le master, mais bien sur il est nécessaire à de nombreux projets de faire tourner les diverses variantes de Windows comme "esclave" de build.

Jenkins offre de contrôler les slaves Windows via DCOM. Soucis, ce protocole historique a deux modes : "marche" et "marche pas". Autrement dit, une quelconque erreur de configuration se traduit systématiquement par un "Access is denied. [0x00000005]" sans plus d'explication.


Bien plus grave, les différentes astuces référencées sur le wiki et récemment mises au propre par Jesse nécessitent toutes de bricoler les droits système et le registre Windows, sans compréhension claire de l'impact de ces changements sur le système. Il n'est pas exclu qu'on ouvre par ce biais une énorme faille de sécurité. Bonus, il s'avère que les versions 64 bits de Windows se comportent assez différemment, et nous avons des retours assez étrange sur l'utilisation de Windows 8. Je ne vous parle même pas des versions "serveur" de Windows (dont je n'ai jamais compris ce qu'il a de "serveur" mais bon).

Nous décourageons donc à nos clients d'utiliser ce mécanisme. L'approche alternative utilise Java Web Start, autrement dit la création d'une connection à l'initiative de la machine Windows, ce qui coupe court aux problèmes de sécurité. Installé comme service windows, l'agent jenkins slave va donc se connecter au Jenkins master au démarrage. Dans de nombreux cas c'est très nettement mieux, cependant il s'avère que cette connection est parfois instable, pour des raisons encore inexpliquées, et bien difficile à diagnostiquer.


Une autre solution, qui s'avère plus stable, est de remplacer le slave Windows par un slave GNU/Linux. Pas de panique, je parle en fait d'installer Cygwin sur la machine Windows, pour la "GNU-ifier" et d'y faire tourner un service openSSH. La machine peut alors être contrôlée par Jenkins comme n'importe quel esclave Linux SSH, ce qui accessoirement unifie l'infrastructure de build.

Ce qui est triste dans l'affaire c'est de se dire qu'on aurait pas besoin de toute cette tambouille si Windows avait un server SSH natif :'(



05 juin 2014

Docker "Oignon" FileSystem

Pour présenter le mécanisme de fichiers 'en couches' utilisé par Docker (Union File System) David s'amuse à lancer un container ubuntu, faire un méchant rm -RF /, quitter le container et relancer la commande pour montrer que "de retour dans le containeur, le file système est clean".

L'effet attendu est atteint, à savoir faire prendre conscience au public, plus habitué à FAT32 qu'aux capacités des filesystems avancés de type ZFS, du mécanisme de copy-on-write et d'empilage de couches sur le filesystem en mode delta.

Pour ce qui me concerne, je présente souvent ce mécanisme comme du "oignon-filesystem" pour bien montrer ce concept de couches fines empilées, qu'on peut à volonté dépiler/empiler sous réserve de respecter le même ordre.


Nous jouons cependant un peu avec le feu en introduisant une fausse idée sur ce qui se passe. Histoire de rétablir un peu de rigueur, explication de texte :

Lorsque vous lancez docker run -i -t ubuntu /bin/bash, docker crée un container avec le filesystem ubuntu en read-only et active une "couche" AUFS en copy-on-write que vous allez modifier lors de vos actions dans le shell - par exemple via un rm -rf /.

Lorsque vous quittez le shell, le container s'arrête - mais il existe encore pour le démon docker, il est simplement à l'état stopped. Vos modifications sont bien là, stockées par AUFS, il n'y a juste plus aucun process qui y accède.

Lorsque vous relancez la commande docker run -i -t ubuntu /bin/bash vous créez un second container, strictement équivalent au précédent lorsqu'il a été lancé initialement. C'est d'ailleurs le point intéressant en termes de processus de développement / déploiement : la reproductibilité de votre livrable.

Cependant nous ne sommes pas à proprement parlé "revenus dans le conteneur". Nous pourrions par contre relancer le container initialement modifié avec la commande docker start  pour relancer le conteneur initial. Comme il n'est pas évident d'obtenir les ID des conteneurs ni de les mémoriser, si vous voulez jouer à ça je vous conseille de nommer vos containers.

Bon ceci dit, ceci est juste une petite mise au point théorique, dans la pratique relancer un conteneur arrêté n'a pas un intérêt énorme amha par rapport à la possibilité de relancer un conteneur tout propre, sachant que les données que l'on doit persister sont confiées à un volume, autrement dit un répertoire de l'hôte.

Le seul cas d'utilisation que je peux imaginer - qui est tout de même non négligeable - c'est le diagnostic post-mortem d'une appli que vous avez lancée via docker et qui s'est arrêtée. Docker start vous permettra alors de lancer un bash et d'aller inspecter le cadavre.


04 juin 2014

Containerization vs Virtualization

En accompagnant David Gageot pour un East-JUG-Docker-Tour nous avons pu discuter de nos approches de présentation respectives et de la difficulté de bien faire comprendre un concept fondamentaux qui est la clé de voute de Docker : les containers.

Tel que je le présentais jusqu'ici, vu les questions qui suivaient la présentation, il est clair que j'allais trop vite et que du coup le message passait mal. David a repris toute cette partie pour l'expliciter dans le détail avec démos d'illustration. Nous testerons le résultat sur le public Strasbourgeois ce soir ...

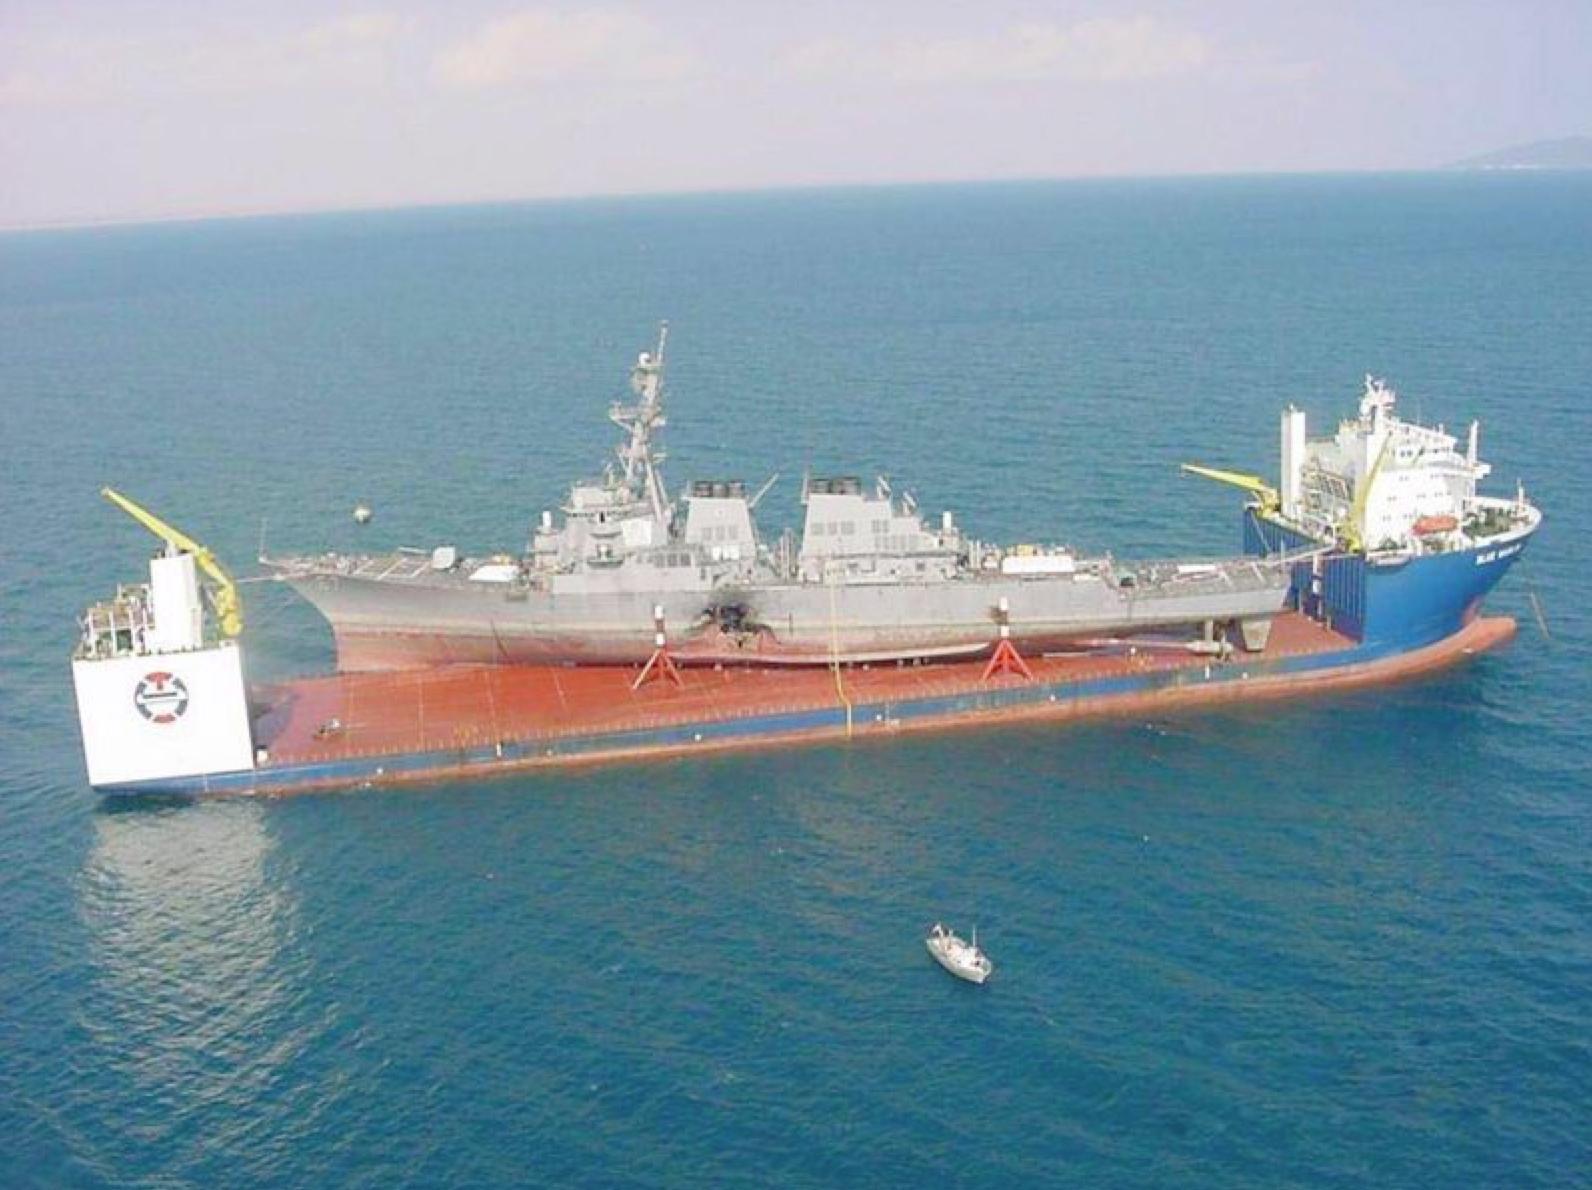
Une image m'a été suggérée par Guillaume pour illustrer la différence entre un container et l'approche "à la virtualbox". Je l'ai intégrée à la présentation, car c'est le genre d'image choc qui marque les esprits et aide donc à bien mémoriser le concept.


A propos d'image marquantes, une photo souvenir. Pour la petite histoire, dans le train qui nous transportait de Nancy au prochain JUG de ce East-Tour, scotchés à nos écrans à essayer de bosser un peu (tout de même) et entendant le haut parleur crachoter l'annonce "notre train va arriver en gare de S..a..bourg" nous sommes descendus sans broncher, même pas surpris par la taille très modeste de la gare. Le temps de réaliser notre erreur, le train était reparti. #Boulets


02 juin 2014

Docker-tour squatt

Suite au succès de la session "la révolution Docker" à Devoxx, je me suis proposé de faire un petit tour des JUGs sur ce thème. Après consultation des organisateurs, il s'est rapidement avéré que David Gageot avait eu la même idée (j'ai du rater un tweet ...). Je passe donc du statut de speaker à celui de ... squatteur.


Blague à part, cela devrait être enrichissant de comparer nos approches du sujet. Rendez-vous demain 4 juin à Nancy et mercredi 5 juin à Strasbourg.

28 mai 2014

Publier sur Parleys

De retour du BreizhCamp, nous voici avec quelques Go de vidéo AVCHD à publier.

L'encodage de ces vidéos n'est pas distribué pour des raisons de volumétrie. Il faudra qu'on réfléchisse à une façon de gérer ce "problème" un jour, mais dans un premier temps j'ai Adobe Media Encoder qui tourne toute la nuit chaque jour, suivi d'un upload sur Youtube - je n'ai malheureusement pas la fibre, mais bon, l'encoding reste plus long que l'upload, donc ce n'est pas le facteur limitant.

Les vidéos sont donc mises à disposition sur la playlist BreizhCamp 2014 du BreizhJUG.

Le montage sur Parleys est une étape qui s'est grandement simplifiée au cours des années. C'est aujourd'hui une appli HTML5 directement intégrée au site. Si vous voulez nous aider, contactez team@breizhcamp.org pour être ajouté comme publisher.

Allez sur le channel du JUG sur lequel la session sera publiée. Cliquez "Add presentation" et indiquez le nom du talk tel qu'il est défini sur le programme.

Dans la session (vierge) qui s'affiche, sélectionnez "timeline", la partie édition de parleys s'affiche alors. Sélectionnez la Lirary, c'est ici que l'on va importer le contenu à monter : vidéo youtube et slides PDF.

Il suffit ensuite de glisser/déposer la vidéo dans la timeline, puis de sélectionner les slides PDF, lancer la vidéo, et tapper s+space à chaque changement de slide par le speaker - en vérifiant qu'il ai bien suivi l'ordre de ses slides :P. L'onglet "shortcut" indique d'autres raccourcis pour un montage rapide sans galérer avec la souris.


S'il y a un phase de démo, insérer une "chapter" vide, ce qui masquera les slides dans le lecteur parleys pour n'afficher que la vidéo (éventuellement en plus grand, selon la configuration sélectionnée par l'utilisateur final).


Choisissez un moment représentatif de la session pour capturer un image de couverture via le tab "Settings". Dans la partie "attachement", glisser/déposer les slides de la librairie,


quand tout semble ok,  [Publish] !

Le talk sera alors disponible à l'état staging. L'édition des méta-données (speakers, résumé) consiste à reprendre les infos du programme. Si vous n'avez pas ces infos (nouveau speaker dont vous n'avez pas l'e-mail) on s'en chargera, le gros du boulot aura été fait de toute façon. Indiquez juste l'état "staging" dans le spreadsheet, qu'on sache qu'il n'y a que la dernière étape de publication à prendre en charge


25 mai 2014

Machistes ?

On nous a signalé cet article sur la programmation du BreizhCamp.

Il y es dénoncé le machisme du comité de sélection qui aurait écarté les femmes du programme.
D'une part, je ne sais pas sur quels chiffres ces bien-pensants se basent, mais je n'ai jamais vu plus de 2 à 4% de femmes dans une équipe de développement - je parle bien de développement, pas de l'IT en général, le chiffre monte alors à 20% et quelques d'après le syntec, ce qui reste peu - j'ai l'impression que l'auteur se base sur ce chiffre quand il note "l’inégalité est flagrante, bien plus importante que la proportion réelle de femmes dans le domaine". Dommage de se baser sur des chiffres aussi générique lorsqu'on parle d'un domaine très ciblé.

Nous avons retenu 3 filles au programme et non une comme indiqué initialement par l'article, soit 50% de réussite à l'épreuve du call-for-papers, comme pour les hommes. Nous sommes en effet neutres et ne faisons pas de discrimination positive sur le sexe du speaker. Ce serait contre-productif à mon avis en proposant des sujets de moins bonne qualité et en les associants finalement aux speakeuses. Certaines femmes techos proposent d'excellent sujet, et n'ont pas besoin de cela pour être retenues.

On nous accuse aussi d'avoir une équipe 100% masculine à sélectionner les propositions. C'est en effet le cas, Marie-Christine étant partie à d'autres occupations, mais nous n'avons jamais communiqué la liste des membres du comité de sélection, il s'agit donc à nouveau d'une conclusion gratuite.

On nous accuse de ne pas prendre en compte le cas de femmes dans l'IT. Ca tombe bien, un sujet était au programme pour présenter Women in IT, co-présenté par un des organisateurs à l'initiative de ce mouvement sur Nantes.

Je suis moi-même membre de JDuchess, et bien que peu actif je pense être sensibilisé et tenter d'y apporter des réponse concrètes, comme d'héberger une après-midi Devoxx4Kids pendant le BreizhCamp et promouvoir ce mouvement, actuellement le meilleur moyen pour que la prochaine génération ne plafonne pas à nouveau à 2% dans les domaines techniques. L'un des membres de l'équipe (Nicolas Ledez) anime tout au long de l'année des ateliers, et est donc très impliqué dans la démarche.

Quand aux "maladresses (photos ou ton déplacé)" notées par l'auteur, qui sont en général le fait de quelques speakers et non des organisateurs, pour les femmes présentes que je connais elles sont bien vécues - certaines n'étant pas les dernières sur le sujet.

Alors quand je lis un article tirant de mauvaises conclusion sans plus de recherche, sur un site qui se veut observatoire du machisme dans les tech et de toute évidence bien mal informé, ça me fait mal. L'auteur, déjà contacté par quelques uns d'entre nous n'a pour l'instant pas répondu, en dehors d'un update mineur sur son décompte des speakeuses.

Je n'ai aucunement l'intention d'imposer un guide de bonne conduite à l'américaine. Au BreizhCamp il y aura aussi des gros mots, voir même quelques trolls contre PHP ou Python, j'espère que l'observatoire du bon parlé français ou le site des Pythonistes-béliquex ne nous en voudront pas - d'autant plus que c'est le but de la conférence : confronter les points de vue, parfois sur un ton ... canaillou :P. Donc si tu es une femme, que tu peux nous parler de la supériorité de PHP sur Java, et le tout sans le moindre gros-mot, tu es la bienvenue - par contre, pas de mauvaise blague sur les gens de couleur (*) ni sur les tendances sexuelles, on ne veut pas d'ennuis avec un autre site bien-pensant.

(*) nous avons un asiat' dans l'équipe. Il s'est de lui même proposé pour faire des sushis. Nous avons même quelque SysAdmins, c'est dire si on est ouverts.


14 mai 2014

workflow plugin

Il y a parfois des coincidences.

Je publiais hier un billet expliquant pourquoi j'abandonne le build-flow plugin au bon soins de la communauté. Quelques heures plus tard Kohsuke annonçait sur la mailing list jenkins son plugin de workflow.

Nous nous serions concertés pour faire un lancement produit nous n'aurions pas fait mieux ! Mais non, c'est juste une coincidence :P

Ce nouveau plugin n'est pas à proprement parler la continuité du build-flow, même s'il en partage certains aspects. On retrouve un DSL qui décrit le workflow, mais ici l'unité de base n'est plus un job, mais un build-step, qu'on va exécuter sur un slave donné.

Le plugin est encore assez jeune mais permet déjà de définir des choses comme :

git.checkout( repo: “git@sm.com:app.git”, branch: “master”)
mvn “install”

je ne doute pas que KK ai prévu tout le nécessaire pour que chaque plugin jenkins puisse ajouter ses propres mot clé au DSL et l'enrichir...

En regardant les slides de présentation, je me demande si ce même DSL (réduit) ne pourrait pas être utilisé pour définir le build via un fichier à la travis, autrement dit un .jenkins stocké dans le SCM dans lequel vous définiriez les étapes de build et tout ce qui va bien pour votre project, ne déclarant dans jenkins que la partie SCM.

A réfléchir ...

12 mai 2014

build flow future

Depuis trois ans je développe par petites touches le plugin Jenkins Build Flow, dont l'objectif est de fournir une solution d'orchestration de jobs jenkins, pour des process de build non triviaux et non nécessairement linéaires. L'idée est de reposer sur un DSL pour exprimer les relations entre jobs d'un même "pipeline", de manière concise et centralisée - et non dans chaque job via divers plugins spécialisés.

Ce plugin a été largement adopté (3500 installations) malgré tout je l'ai toujours considéré en phase expérimentale (d'où le numéro de version : 0.11). Ce succès a révélé un effet de bord majeur : de nombreux utilisateurs ont exploité la syntaxe Groovy du DSL pour venir "bidouiller" Jenkins à l'aide du build-flow. Initialement je pensais que le DSL devait être un pur langage indépendant des APIs de Jenkins, ce qui permettrait de faire évoluer le moteur interne. La facilité de créer un DSL en Groovy et l'absence totale d'expérience de ma part dans ce domaine a ouvert la boite de pandore. Aujourd'hui il est impensable de conserver la compatibilité et de revoir l'implémentation du moteur.

Or le build-flow a un défaut majeur : ce n'est pas une machine a état qui est modélisée puis exécutée, mais un thread java qui est lancé. Impossible de figer le flow (redémarrage de jenkins), de reprendre à flow à une étape précédente (reprise après erreur), etc. Bref, de prendre en charge des process de développement réellement complexes et de correspondre à ce que fait par exemple le plugin build-pipeline pour les cas "linéaires".

Bloqué par ce problème technique, je n'ai plus travaillé sur le plugin depuis un moment, et je manque de temps et d'idée pour m'y atteler. Accessoirement je n'utilise pas ce plugin moi même, le dogfood étant le meilleur moteur pour faire avancer un projet, celui-ci s'enlise.

J'ai donc décidé d'abandonner ce projet, qui est à la disposition de la communauté -  en termes d'écosystème Jenkins cela signifie que le premier qui prend le temps de le maintenir devient mainteneur officiel. J'ai lancé un appel à volontaire sur jenkins-dev. Si vous êtes tenté, je suis évidemment disposé à vous expliquer en bon Français le pourquoi du comment avant de vous passer la main, contactez-moi.

Ce plugin ayant ses fans, déçus par les tentatives de recentrage que j'ai appliqué après la version 0.10, je ne doute pas que quelqu'un prendra la main dessus, et le fera évoluer selon ses besoins. Il ne correspond plus à ma vision, mais peut tout à faire correspondre aux besoins de nombreux autres utilisateurs.

Kohsuke travaille sur un nouveau plugin de workflow. Je n'ai suivi son initiative que de loin pour le moment et je ne sais pas très bien le recouvrement. Je sais juste qu'il a profité des enseignements du build-flow, même si nous n'en avons pas nécessairement la même perception. Wait'n see.


07 mai 2014

test des accès base

Je vous présentais hier un petit outil bien fait pour écrire les tests d'API REST. Sur une application qui fait autre chose qu'un hello world, il faut cependant "bouchonner" les resources externes pour rendre ces appels prédictibles et donc reproductibles dans le cadre de tests automatisés.

Une pratique courante de test consiste à utiliser des Mocks, en considérant qu'on veut valider l'utilisation d'un système tiers, pas son implémentation. Dans le cas un peu particulier d'une base de donnée cependant on est confronté à un problème : le SQL

Les accès à la base de donnée sont en effet liés à son interprétation de ces fameuses requêtes, et le seul moyen de s'assurer que leur syntaxe est correcte, correspond au schéma de la base de données, et retourne bien les données attendues, c'est ... de l'exécuter.

Que l'on fasse du JDBC à l'ancienne ou qu'on utilise un outil de requêtage type-name-safe comme jooq le problème reste le même, une requête n'est vraiment fiable que si on a pu la valider sur une base de données réelle. La solution que tout le monde (?) utilise est une base de donnée H2 - base qui tourne en mémoire - ce qui permet de démarrer rapidement et sans complication une base juste pour la durée des tests. Je me suis fait une Rule junit pour monter cette base H2 et appliquer les scripts de création du schéma, qui sont - évidemment - stocké dans mon repo Git avec le code de mon appli (what else ?).

Pour mettre la base dans un état donné et valider le résultat de mes requêtes, à la recherche d'une solution sympa, légère et qui soit un peu plus productive que des fichiers xml DBunit, je suis tombé sur dbassert.

    @Rule
    public InMemoryDataBase dataBase = new InMemoryDataBase();

    @Test
    public void list_items() throws Exception {

        DbAssert db = DbAssert.init("dbassert.yml");
        DbSource h2 = db.source("h2", getClass());
        h2.clean_table("items");
        h2.fixture("items");

        // Proposal returned
        when()
            .get("/items")
        .then()
            .assertThat().body(containsString("Test item"));

    }

Ca reste un chouille verbeux, donc pour faire clair :

le init consiste à configurer DBAssert pour accéder à la base de test. La DBSource sert à définir où trouver les fichier de données - dans le même package que la classe indiquée. On applique ensuite des fixtures, des fichiers yml de données pour la table du nom correspondant. On peut de même comparer l'état de la base après un update.

Quelques points négatifs qui me font penser que c'est un projet encore jeune, ou bien qu'il y a mieux ailleurs :)


  • le projet est sous SVN sur google code. Clairement pas adapté pour la contribution a l'aire de GithHub.
  • la librairie n'est pas disponible sur maven central. J'ai fait un export des sources dans mon src/test/java, vu qu'il n'y a que quelques classes
  • l'API est perfectible. Je voudrais pouvoir initialiser DbAssert via une DataSource - que j'ai préparée par ailleurs dans ma InMemoryDatabase  - plutôt que via un fichier yml
  • l'application d'une fixture utilise un INSERT bête et méchant, sans rechercher les données déjà insérée. On doit donc faire un clean_table systématiquement.
Rien de bien grave, qui devrait pouvoir se corriger via une petite contribution (d'où le premier point).

Si vous connaissez un autre outil comparable, je suis preneur de vos retours d'expérience.


05 mai 2014

test de services Rest

Il y a quelques années, lorsque je développais des applications web (avant de devenir essentiellement un développeur  middleware/backend) il y avait une explosion de frameworks MVC. Struts, WebWork, Wicket, Stripes, pour n'en citer que quelques-uns.

Les applications actuelles tendent vers un modèle à base de vue riches JavaScript et un backend REST, et on voit émerger une foultitude de Frameworks JavaScript et de backend REST.

Je n'ai jamais été très fan des tests web, selenium ou htmlunit, qui ont toujours été délicat à stabiliser et bons pour la casse à la moindre refonte de l'UI. L'évolution vers une architecture JS+REST a l'avantage de permettre au moins de tester facilement la partie REST - je n'ai pas encore exploré les solutions pour la partie Web à proprement parler, c'est quelque part dans ma todo-list ...

Comme toujours, il y a pléthore de frameworks pour un même besoin, chacun avec ses propres spécificités et avantages. Je n'ai pas l'ambition de vous dire avoir trouvé la perle rare ni proposer un palmares exhaustif, vu que je n'en ai essayé qu'un : Rest-assured.

Ce que j'aime bien dans Rest-assured c'est la syntaxe très, très simple et lisible des conditions de test et des assertions, très inspirée de l'approche BDD ("given/when/then") :

    @Test
    public void should_create_user() {
        given()
           .body("{ \"name\": \"nicolas\" }")
        .when()
           .post("/users")
        .then()
           .assertThat().statusCode(CREATED);
    }

Très peu de code parasite dans la description d'un tel test d'API. Que le scénario de test soit lisible même par ma grand-mère (ou pire : ma MOA) comme le voudraient les partisans des tests fonctionnels m'importe peu, par contre que je puisse rapidement définir une condition de test sans partir dans des imbrications d'API sans fin, ça me parle.

L'approche "fluent" (qu'on appelait Builder Pattern dans le temps, mais c'est moins hype) apporte aussi beaucoup en lisibilité. En gros, si on fait abstraction de la ponctuation on peut lire une phrase quasi naturelle (enfin, humanoïde quoi), c'est ce qu'on appelle un Domain Specific Language. On retrouve ce pattern dans tous les frameworks récents, et les lambdas de Java 8 aident pas mal à étendre cette approche à de nouveaux cas d'application.

Ce que je constate surtout, c'est qu'à côté l'explosion des frameworks applicatifs on a aussi une explosion de l'outillage de test, souvent (toujours ?) la cinquième roue d'un développement, mal ficelé, mal entretenu, mal outillé. Pour ce qui me concerne je les redécouvre tardivement. Ne faites pas la même erreur que moi, gardez un oeil sur vos tests et la boite à outil qui va avec.


Bon ceci dit, c'est bien connu "tester c'est douter". Perso j'ai appris à mes dépends à douter et à prendre quelques précautions pour éviter les mauvaises surprises.


Small is beautiful

Faire des tests rapides, un build qui ne dépasse pas quelques minutes, ça reste un voeu pieux confronté à une appli de centaines de milliers (millions?) de lignes avec une architecture alambiquée. Je ne jette la pierre à personne, j'ai moi même largement contribué à rendre ces applications alambiquées à grand coup de Spring-truc et d'AOP.


Aujourd'hui, avec du recul et surtout en travaillant dans une équipe totalement distribuée (donc où il faut savoir limiter les besoins de synchronisation et  de communication), j'apprend les mérite d'une autre approche.

Vive les micro-services.

Le concept de micro-service est expliqué en détail par Martin Fowler et James Lewis. 

Une application mastodonte-monolithique est délicate à faire vivre et ardue à appréhender. Le découpage en couches à la JavaEE et les modules maven associés ne changent pas grand chose à la donne, et au contraire ont tendance à figer de possibles mauvais choix. Si par exemple j'ai développé mon UserRepository avec plein de beaux tests, et que je veux faire un savant refactoring de mon modèle, je vais m'assoir sur tous mes tests, car ils sont ciblés sur la vision de mon architecture à un instant t, alors que le besoin de départ est fonctionnel. On touche ici au distingo test unitaire / test fonctionnel. 

Selon une approche micro-service, plusieurs applications spécialisées prennent en charge des domaines métier restreints. Une équipe plus spécialisée et plus restreinte s'occupe de ce "fragment" et peut plus facilement le faire évoluer. Dans le cas d'une équipe distribuée à la CloudBees, ça donne des équipes de 1 :-)  Chaque service étant très spécialisé et ciblé il est facile de rentrer dans le code "en renfort".

Ces micro-services communiquent ensemble via des APIs, et peuvent utiliser des protocoles binaires pour limiter l'impact d'un appel HTTP sur les performances, mais ce qui compte ce sont les frontières qu'on a défini dans le modèle métier.


Ces frontières et la réduction du scope allègent grandement chaque service et permettent de mettre en place des pratiques de développement efficaces, et d'augmenter l'agilité de chaque service. L'agilité de l'application dans son ensemble s'améliore aussi, malgré un surcout de synchronisation des développements de chaque service. C'est un peu le principe des scrums-de-scrum.

Autre bénéfice qui émerge rapidement, chaque micro-service peut avoir sa propre architecture, voir son propre langage d'implémentation, et donc mieux répondre au besoin "local". 

Ce n'est pas forcement lié, mais si on ajoute Docker dans l'équation, tous ces services peuvent tourner sur la même machine et la communication entre micro-services a alors un coût minimal. Docker permet de donner des quotas à chaque service, et donc d'identifier facilement lequel part en vrille lorsque c'est le cas - ce qui est souvent un challenge ardu sur une grosse appli monolithique. Il permet aussi de gérer un dimensionnement différent de chaque service, un cycle de vie différent, etc.

Bref, vous l'aurez compris, je suis fan :)

02 mai 2014

To test or not to test ?

Pendant des années j'ai fait la promotion des tests unitaires, expérimenté tout un tas d'outils (c'est le côté rigolo) sans moi même trop me plier à la pratique. Je pouvais prétexter intervenir sur des couches techniques et/ou d'intégration qui sont d'un compliqué ma pauv' dame.

Bref faites ce que je dis, pas ce que je fais.

J'ai utilisé le TDD une fois lorsque j'ai voulu ré-implémenter fonzie proprement (la version initiale étant au mieux un jouet, ce qui n'a pas empêché de le mettre en production, m'enfin). Il faut reconnaître que ça marche du tonnerre si on arrive à se discipliner.

J'arrive après la bataille et je ne vais donc pas vous faire l'apologie des tests unitaires, d'autre l'ont fait et le font encore bien mieux que moi avec nettement plus de crédibilité. Ce que je constate par contre, c'est que c'est une pratique qui a un impact fort sur les choix d'architecture et de frameworks.

Architecture : une grosses appli Java EE de centaines de milliers de lignes, avec toute la bonne volonté du monde ça met vite un temps fou à builder/tester. Je pourrais vous parler de micro-services (un autre jour ?) mais il est évident qu'avec une suite de test qui prend plusieurs minutes et écroule la machine, le développeur ne va pas lancer les tests régulièrement, ni sans doute avant de committer des modifs mineures (sic!) sauf à faire la police dans l'open-space - bonne ambiance garantie.
Ca veut donc dire qu'il faut savoir cibler les tests à l'essentiels, le 100% de couverture qui teste tous les getter/setter (si si, y'en a) n'apporte vraiment que du surpoids au projet.

Frameworks : Je vous parlais hier de fluent-http, et sans surprise ce framework web permet d'écrire des tests très léger et très rapides. Il sait démarrer sur un port libre aléatoire (ce qui permet aux tests de tourner en parallèle), et ce en quelques centaines de millisecondes.

public class MyResourceTest {

    @BeforeClass
    public static void runWebServer() throws Exception {
        WebServer server = new WebServer(routes -> {
            routes.add(MyResource.class);
        }).startOnRandomPort();
    }


    @Test
    public void should_create_user() {
        given()
           .body("{ \"name\": \"nicolas\" }")
        .when()
           .post("/user")
        .then()
           .assertThat().statusCode(CREATED);
        // TODO test database insert was successful
    }
}


Ce tout petit test me permet de tester mon service REST, il manque juste un peu de mocking pour la partie backend. Il est de niveau API, donc orienté fonctionnel, et me permet de jouer avec l'implémentation.

Jouer c'est bien le mot, car avec des tests aussi rapides, on peut activer infinitest.

Infinitest joue les tests à chaque modification de code (compilation si vous utilisez IntelliJ Idea). On va donc tripatouiller le code par petites touches, Cmd+S et hop le test vérifie qu'on a pas tout cassé et/ou qu'on a enfin réussi à implémenter la fonctionnalité attendue.

On est donc dans une logique de type micro-intégration-continue, très très efficace. Evidemment, si vous n'avez pas des tests rapides, ça n'est pas d'un grand intérêt. C'est donc un ensemble complet de pratique, d'outils, et d'architecture auquel il faut s'attaquer, tous d'un même front.

Pour en arriver là sur des projets non triviaux, il faut aussi savoir découper son appli correctement. Mais je vous parlerais de micro-services une autre fois :)


30 avril 2014

fluent-http, un amis qui vous veut du bien

Le Call-for-Papers du BreizhCamp est une appli custom développées au fil du temps libre l'an dernier et un peu rafraichie cette année. J'ai pour ambition d'en faire une appli "as-a-service" pour toutes les conférence qui veulent bien s'en servir (n'est-ce pas un super business model ?)

Pour arriver à ce résultat, un grand coup de ménage s'impose, et c'est donc l'occasion pour toute équipe de dev de critiquer les choix techniques "historiques" et essayer de nouvelles choses.

J'ai été tenté par Spring Boot, pour finalement me tourner vers fluent-http. Plusieurs raisons à cela :


  1. fluent-http est un framework tout neuf, c'est donc motivant d'y mettre son nez
  2. fluent-http est fait par l'équipe codestory, avec tout plein de Gageot-eries dedans, et donc c'est beaucoup plus sympa de se dire qu'on peut en discuter avec eux autour d'une bière.
  3. fluent-http est incroyablement léger et rapide. Cela permet d'écrire des tests unitaires (voir plus loin) efficaces
  4. fluent-http nécessite java 8, donc pas d'excuse, il est temps de se mettre aux lambdas et pourquoi par de mettre null hors d'état de nuire à grand coups de Optional.
  5. ça nous fera un sujet pour proposer une conférence :)

L'un des points techniques majeur qu'apporte fluent-http c'est la légèreté. Le serveur démarre en vraiment pas longtemps, et s'il ne supporte pas (encore) le hot-reload le cycle stop/restart prend plus de temps à cliquer qu'à attendre le serveur. Pas d'initialisation à la Spring à parser du XML ou à scanner le classpath à la recherche d'annotations, fluent-http est taillé pour démarrer vite avec juste ce qu'il faut. 

Le "juste ce qu'il faut" est aussi amha un point important. A utiliser des frameworks sensés nous simplifier la vie, on finit par se créer des contraintes et perdre un temps fou sur des problèmes d'intégration. 

Exemple concret : sur la version initiale du CfP, écrite en Play/Java+Angular, la sécurité est confiée à SecureSocial. Sur le papier c'est génial, trois fichier de conf et roule ma poule. Dans la réalité, lorsqu'on veut introduire du multi-tenant, utiliser l'email comme clé d'identification des utilisateurs, etc, on galère (surtout quand l'implémentation LinkedIn ne récupère pas l'email). Ajoutez quelques bugs (?) : je m'inscrit avec github, je fait ma cuisine, je tente de me reconnecter avec Google, et là j'ai un nouveau compte. Ballot non ? 

Au final j'ai passé pas mal de temps à comprendre la structure de SecureSocial, puis finalement a en forker un bout (pour le multi-tenant). C'est certes intéressant, mais tout bien pesé, implémenter mon propre login en comprenant les mécanismes OAuth2 ne prend pas nécessairement plus de temps (la preuve).

Donc, faut-il tout recoder sois-même ? Non, soyons réalistes. Faut-il mettre des frameworks pour tout juste parce qu'ils couvrent mon besoin (plus tout un tas de trucs) ? Non. C'est ce en quoi je ne suis pas fan de JHipster. Sur le papier c'est super, mais rien que la structure de code générée par défaut me fait peur. On peut débattre du bienfait d'avoir tous ces outils pré-cablés, qui seront nécessaires à un moment ou à un autre et ne coutent pas plus cher, mais personnellement ça ne me donne pas envie. J'ai par exemple peur de ce que va devenir mon build Grunt que je n'ai pas du tout conçu moi même. En gros, on m'impose des outils dont je ne sais rien, que je n'ai pas demandés, et que je ne maîtrise pas.

fluent-http se contente (sic) de prendre en charge la couche HTTP et l'exposition de resources REST, en ajoutant le support de templates html. Juste ce qu'il me faut, à moi de définir sur mesure ce que je veux ajouter dessus, au cas par cas.

J'ai glissé un mot sur les tests. Et oui, ça sent le Gageot entre chaque ligne de code. Fluent-http est très rapide à démarrer, non pas pour booster vos serveurs de production (quoi que ...) mais surtout pour permettre d'écrire des tests web rapides. 

Je vous en dirais un mot vendredi, il parait que c'est bien de faire un billet de blog par jour :)


16 avril 2014

la rançon du succès

Si vous ne le saviez pas, cette semaine c'est DevoxxFrance...

Je ne vais pas vous parler des divers talks de la journée, mais d'un événement tout à fait indirect.

Les organisateur de Devoxx on en effet du faire face à de la publicité sauvage, sur le trotroir juste devant le centre de conférence :


Ce marquage est fait au karsher, c'est donc écrit en "propre sur fond sale", rien à reprocher en termes de la dégradation de la voie publique.


  • D'un point de vue communication c'est inattaquable et  assez génial, il faut l'avouer
  • Du point de vue de DevoxxFrance, c'est une marque de reconnaissance indirecte : se faire ainsi "hacker" pour une campagne de pub, c'est montrer qu'ils sont incontournable.
  • Du point de vue du respect de la conférence, c'est nettement plus discutable. DevoxxFrance vie de l'énergie d'une quinzaine de bénévoles, et avec l'aide de sponsors qui payent leur place. Détourner ainsi cette énergie à des fins de promotion pirate est assez lamentable. En écrivant ce billet je me rend compte que je relaie leur message, mais en même temps j'espère vous faire comprendre à qui vous avez affaire. Détourner ainsi, sans contrepartie, les efforts d'une équipe qui se plie en quatre pour faire bouger notre écosystème, c'est minable.

Donc, si vous cherchez du taf, dites le moi, je publierais les CV des 10 premiers qui me contactent, juste pour montrer qu'il y a des manières plus respectueuses de faire les choses.

14 avril 2014

Jenkins meets Docker - round 2

On my previous blog post I explained how to use docker from Jenkins.


I can see some issues with this setup :


  1. You have to register the docker image you want to use as a slave in Jenkins global configuration, and rebuild the image when your environment requires some changes. 
  2. Dockefile has to define a ssh server, just to act as a jenkins slave, unrelated to your project needs.
  3. Docker plugin isn't elastic, even being a "Cloud" Jenkins plugin. It relies on a static docker-enabled host to run containers. I'd like to keep the Cloud principle to get resources as needed.


So, please welcome oki-docki jenkins plugin. This is still an experimental, unreleased, work-in-progress, use-at-your-own-risk plugin, but here's the concept :

You use your SCM to store both project source code, build script and a Dockerfile that describes your build environment. oki docki will use your Dockerfile to build+run a container and execute build script.


Plugin actually

  • checks project workspace for a Dockerfile
  • computes its hash, to detect changes
  • search for an existing docker image to match, build one if required
  • run a container, mounting build workspace in container as /var/workspace
  • executes build script

You may notice the docker image isn't pushed to a repository. This is intentional. I like the idea I can rebuild my docker image at any time from scratch, not relying on some binary deployed somewhere. Thanks to Docker incremental build, this isn't such time-consuming.


Benefits :


  1. no need to setup anything on jenkins, just have docker-enabled slaves. I'm using a "docker" label for this purpose. This one can benefit from jenkins Cloud slave providers.
  2. Dockerfile just defines requirements to build your project. All yours to select a specific JDK, system packages or nodejs version. The same Dockerfile can be used by developers to get a ready-to-use development environment.
  3. project Dockerfile is stored in SCM, with application code and build scripts, and all is kept in sync without manual steps. You can have a distinct Dockerfile in a branch if needed.


The current implementation is more a Proof-of-concept than a production-ready plugin, but already let you run a build inside Dockerfile. My initial goal was to start the container and then let jenkins run any regular build steps inside, but this require some Jenkins-remoting redirection hack, which development skills I don't have. On the other side, I also think it make sense to define your CI process as a script store in SCM, not relying on a set of build steps configured in jenkins (must admit I like travis-ci approach on this topic).

I plan to demonstrate this at DevoxxFrance during my talk "La révolution Docker" - assuming I don't break my environment in the meantime :)


08 avril 2014

Jenkins meets Docker - round 1

I'm investigating Docker usage in a Jenkins context, and would like to report here progress I made so far.


Step 1 : get docker up and running

My development laptop is running OSX, so I had to setup boot2docker. Compared to previous docker vagrant environment, this one is missing (sic) port redirection to host, so you for sure can run a container but can't access it :-\

No panic, you just have to run :

for i in {49000..49900} 
do
   VBoxManage modifyvm "boot2docker-vm" --natpf1 "tcp-port$i,tcp,,$i,,$i"
   VBoxManage modifyvm "boot2docker-vm" --natpf1 "udp-port$i,udp,,$i,,$i" 
done

Not a big deal, but I guess lot's of non-Linux users will search google for this tip. I also recommend you to run boot2docker if you're a Linux user, as it's far simpler to "drop" everything in a virtualbox instance vs cleaning up your system after you made some bad docker experiments.

Right, so docker is up and running on my MacBook. checked

Step 2 : create Docker image for jenkins slave (and use jenkins to build them, what else ?)

First thing I want to do is use Docker to manage my build environment. Jenkins for sure has various automated tools installers, but I prefer to manage this my way, with setup script stored within project SCM. With a Docker, I have a simple way to prepare build slave to match project prerequisites, with full isolation between jobs.

So, I need to setup a docker image to act as a jenkins slave. For this I need it to embed a ssh server - would be nice for jenkins to be able to use docker attach to access container, but I don't think anybody tried this yet.

Docker documentation gives you all necessary information to setup a sshd service, anyway that's not fun enough : as a Jenkins-guy, I want my environment setup to be automated and reproducible !

So, I'm using Michael Neale's docker-build-and-publish plugin to build my Dockerfile. This plugin is designed to ... build and publish docker images. Limited scope, do it well. Think about it as "my own trusted builds infrastructure"

I had to tweak my setup a few as recent docker version changed the behavior for ADD keyword. As I'm not much of a system packages fan, I used to ADD tools as tar.gz from a S3 bucket URL, but now only local files are unpacked by ADD command, so I need to first copy them to workspace so docker will expand them. I wonder docker team made such an error-prone choice, and didn't introduce an explicit EXPAND keyword, or something equivalent.

Anyway, after a dozen broken builds (sic) I got my environment setup and container ready to accept ssh connections to start a jenkins slave.

➜  ~ ssh root@localhost -p 49162
Welcome to Ubuntu 12.10 (GNU/Linux 3.13.3-tinycore64 x86_64)

 * Documentation:  https://help.ubuntu.com/
Last login: Tue Apr  8 11:05:01 2014 from 10.0.2.2
root@f720cc089b6c:~# java -version
java version "1.8.0"
Java(TM) SE Runtime Environment (build 1.8.0-b132)
Java HotSpot(TM) 64-Bit Server VM (build 25.0-b70, mixed mode)
root@f720cc089b6c:~# 

Step 3 : use docker containers as jenkins slaves

Then I've setup Docker-plugin to use it later for other jobs, running on the same Docker infrastructure - at this time, docker plugin acts as a Jenkins Cloud extension, but it doesn't offer scalability. I expect to find some way to introduce an alternative design so you can get slaves provisioned by IaaS on-demand (like other Cloud plugins do) and run a container on top of it, probably by using a build wrapper ... will see.

Anyway, Docker-plugin already does the job for my initial setup, just need to know it's using a pure java docker client (jDocker, a docker-java fork - Jenkins folks use to fork anything that doesn't accept pull requests within a week), and as such only support http. So don't set your docker URL as tcp://localhost:4243 as I use to set in .bash_profile for OSX development.

I also got various configuration issues and all sort of compatibility bugs that makes the distinction between documentation and reality :) Anyway, I now can run my demo job on this custom slave environment.


[04/08/14 14:10:21] [SSH] Opening SSH connection to localhost:49192.
[04/08/14 14:10:21] [SSH] Authentication successful.
[04/08/14 14:10:21] [SSH] Checking java version of java
[04/08/14 14:10:21] [SSH] java -version returned 1.8.0.
[04/08/14 14:10:21] [SSH] Starting sftp client.
[04/08/14 14:10:21] [SSH] Copying latest slave.jar...
[04/08/14 14:10:21] [SSH] Copied 364 754 bytes.
Expanded the channel window size to 4MB
[04/08/14 14:10:21] [SSH] Starting slave process: cd "/tmp" && java  -jar slave.jar
<===[JENKINS REMOTING CAPACITY]===>channel started
Slave.jar version: 2.36
Ceci est un esclave Unix
Evacuated stdout
Slave successfully connected and online

02 avril 2014

BreizhCamp 2014 : go, go, go

A nouveau cette année, l'équipe maintenant bien rodée du BreizhCamp est à pied d'oeuvre pour préparer la 4ème édition de la conférence connue internationalement (si, si)

Nouveauté majeure cette année, vu que nous ne parvenons pas à trouver des locaux plus vastes pour vous éviter la déception de ne pas obtenir de place, nous avons étalé la conférence sur une demi journée supplémentaire, mercredi après-midi, pour un hacker-space :


  • une session devoxx4kids, profitons que les nouveaux rythmes scolaires ne soient pas encore en application, nos gamins peuvent encore profiter de leur mercredi pour ... coder.
  • un hackergarten, l'occasion de découvrir un projet open-source et y contribuer avec l'aide d'un de ses principaux committers.
  • des ateliers pratiques divers (voir le call-for-papers plus loin)
  • des démos, en particulier sur tout ce qui touche au hardware et à l'embarqué. Les objets connectés, l'Internet des objets (IoT), et les wearables seront à l'honneur.

Nous avions aussi plein d'idées pour rendre le BreizhCamp 2014 plus beau, plus fort, mais le temps nous manque - la conférence aura lieu les 21, 22 et 23 mai, plus tôt que l'an dernier ... et nous voulons avant toute chose conserver la qualité de la conférence.

L'autre nouveauté c'est l'organisation d'une party jeudi soir, ouverte à tous, pour prolonger tard dans la nuit les discussions de la journée. Plus d'info très bientôt, dans notre newsletter.

Une autre nouveauté, et pas des moindres, c'est la liste de nos sponsors. On y retrouve des fidèles du BreizhCamp: Softeam, Zenika, Serli, CloudBees, Google, SQLi, mais aussi des nouveaux, Github, SonarSource, Sii, et notre second sponsor platinum, Microsoft.

Microsoft ? Et oui, même si le public du BreizhCamp est très coloré Java, la conférence a toujours eu comme objectif le brassage des cultures et les confrontations amicales. Découvrir le cloud de Microsoft ou leur approche fonctionnelle F# est une occasion de sortir de votre zone de confort !

Je vous le disais, BreizhCamp c'est une conférence mondialement reconnue, comme le prouve le sponsoring de GitHub et le speaker qu'ils nous envoient tout droit de SFO. Nous avons ouvert le call-for-papers aux speakers internationaux, nous espérons ainsi vous proposer quelques sujets de tout premier choix.

Le call-for-papers, d'ailleurs, est toujours ouvert (jusqu'au 10 avril). N'hésitez pas à postuler, mais ne tardez pas si vous voulez nous laisser une chance de prendre connaissance de votre sujet et de vous questionner avant le dépouillement.

Cette année, je ne serais pas membre du comité de sélection lors de l'établissement du programme (je ferais le con sur le stand CloudBees de scrum day). C'est aussi une garantie de l'objectivité de notre sélection, étant dans l'organisation de la conférence le "dictateur bénévole", cela laisse à l'équipe toute liberté pour s'exprimer et établir un programme équilibré.

L'équipe, c'est aujourd'hui la clé du BreizhCamp. Si j'ai monté la première édition quasiment seul (un des avantages de bosser pour FT c'est le temps libre que ça laisse), les choses se compliquent et sans mes camarades de jeu je n'irais pas bien loin. Un petit noyau dur donne la dynamique générale, et on y retrouve quelques Javaistes, mais aussi un Rubyiste et un dotNeteu, comme quoi le "mix de technologies", on l'a dans le sang.

Bref, tout ça pour dire que nous vous préparons un BreizhCamp 2014 de haut vol, et qu'il ne faudra pas trainer pour vous inscrire. 250 entrées max, c'est ce auquel nous sommes contraints par les locaux de l'ISTIC (si vous connaissez de super locaux à Rennes ...). Nous avons ouvert des inscriptions early-bird mardi midi, à 20h les 30 places étaient parties. Autant vous dire de surveiller l'ouverture de la billetterie, en suivant @breizhcamp par exemple :)

Cette année, le DIF est pris en charge pas SQLi, nous avons pris grand soin de faire les choses dans les règles de l'art pour éviter les désagréments que certains d'entre vous ont subis l'an dernier de la part de leur RH un peu trop à cheval sur le règlement.

go, go, go !


18 février 2014

Maven est mort ...

vive Maven.

Non, je ne parle pas du projet Apache Maven (ce serait peu scrupuleux de ma part de jouer sur l'ambiguïté et d'écrire un billet de blog avec un titre tapageur) mais du livre Apache Maven, édité par Pearson.

Arnaud et moi avons aujourd'hui reçu ce courrier :


Nous avions été prévenus de l'arrêt de la publication, et avons demandé la restitution de nos droits. Voilà chose qui est donc officielle. Au passage, je m'amuse de voir le livre toujours référencé sur http://www.pearson.fr/livre/?GCOI=27440100730370 et disponible en eBook :P

Bon bref, cette expérience d'édition a été instructive :

  • le travail sous Word avec un template barbare est une horreur
  • le processus de relecture et de PAO est une horreur
  • ça prend un temps fou
  • ça rapport très peu par rapport aux heures consacrées
Nous avons donc décidé de diffuser le contenu librement, après conversion au format AsciiDoc. La conversion étant loin d'être parfaire il reste pas mal de couacs, en plus de ceux présents dans le texte lui même, mais globalement, vous pouvez à présent nous lire de manière totalement gratuite et libre (license CC BY-SA).

https://github.com/ndeloof/apache-maven-book

Si vous voulez nous aider à faire vivre ce livre, vos contributions sont les bienvenues. Sinon il finira de mourir tranquillement en attendant que Maven 4.0 voie le jour. Et si vous regrettez l'époque où vous pouviez nous rémunérer pour ce travail (1,23€ par vente, imposable), nous sommes à votre disposition pour une bière ;-)

28 janvier 2014

Jouons un peu avec securesocial

L'équipe du BreizhCamp est en train de dépoussiérer l'appli Call-for-Papers développée l'an dernier. L'objectif premier est bien sur l'ouverture prochaine du CFP 2014, mais aussi l'hébergement à moyen termes d'un Call-for-Paper "as-a-Service", opensource et gratuit pour les tous les organisateurs de conférences. 

L'idée vient évidemment de ce que je bosse chez CloudBees (ce qui nous permet d'avoir des tarifs d'hébergement imbattables !) et que le développement d'un SaaS multi-tenant est un sujet qui m'intéresse énormément. 

L'idée vient aussi de ce que je suis moi-même speaker, et que j'en ai marre de copier/coller ma bio d'un CFP à l'autre. Avec un seul service sur lequel j'aurais mon profil, je pourrais postuler plus confortablement :)

Bref, ménage de printemps dans le code, qui est fonctionnel mais ... mérite quelques améliorations :) En gros, l'appli a été finalisée l'an dernier PENDANT le call-for-papers, il y avait donc pas mal de trucs plus ou moins bien finis.


L'appli est en Play2 / Java (l'équipe n'est pas très friande de code Scala) et l'UI en AngularJS. Nous avons donc naturellement confié l'authentification à la librairie SecureSocial. Vous pouvez donc vous identifier via les services OAuth github, google, etc.

OAuth

OAuth est un protocole d'authentification qui permet de fournir à une appli l'accès à vos données hébergées par une autre appli, sans pour autant lui donner votre mot de passe. L'application "cliente" vous renvoie vers l'applicable "cible", qui affiche une demande de confirmation, indiquant les droits demandés. Un callback fournit alors à l'application cliente un token pour accéder aux infos demanders. 

La sécurité d'OAuth est basée sur l'enregistrement de l'appli cliente chez le fournisseur de données.Le client dispose un ID+Secret unique qu'il utilise pour demander au fournisseur l'accès aux données - fournisseur qui demande l'autorisation de l'utilisateur - avant d'appeler le callback redirect_url.  


Je ne vais pas vous détailler plus OAuth, complètement pris en charge par securesocial, ce qu'il faut retenir c'est cette redirect_url vers laquelle vous ramène le provider après confirmation de l'accès. Ce callback doit être sur le domaine prévu, ce qui évite une utilisation frauduleuse, en complément de l'ID+Secret.

SecureSocial

SecureSocial est une libraire bien pensée, offrant des API Scala et Java, ce qui nous arrange bien :)

Un problème qui avait émergé dès l'an dernier, est que securesocial nous fournit comme identifiant d'utilisateur l'ID défini par le provider OAuth. Cela veut dire que Jean Dupont identifié par github n'est pas la même personne que Jean Dupont identifié par google. Par ailleurs, l'API de twitter ne permet pas d'obtenir l'email de l'utilisateur - et c'est volontaire. 

Première évolution, l'email devient la clé d'un utilisateur, ce qui autorise l'identification multi provider, et bien sur Twitter passe à la trappe (nous pourrions le rétablir, sous réserver d'obliger l'utilisateur à saisir son email et à le confirmer ... bref ce n'est pas du tout indispensable).

Seconde évolution, j'ai ajouté l'authentification via linkedin. J'ai galéré un moment, avant de comprendre que le provider OpenSocial ne prend pas le scope email chargé de demander l'email utilisateur. J'ai donc du définir ma propre implémentation, l'occasion aussi de remettre un peu le nez dans du Scala, j'aime bien de temps en temps, ça me change de Jenkins...

Détail amusant (?), l'implem' OAuth de LinkedIn ne contrôle pas du tout le domaine utilisé par la redirect_url, ce qui permet de tester même depuis localhost:9000 - de là à se demander si c'est très sécurisé tout ça ...

Troisième évolution, dans le but de faire de notre Call-for-Papers un SaaS, il faut gérer des sous-domaines (breizhcamp.call-for-papers.io, javaone.call-for-papers.io, etc). Vous voyez rapidement le problème, chaque conférence ayant un domaine propre, il faudrait un ID+Secret différent sur chaque provider OAuth. L'idée est donc que la page de login soit sur www.call-for-papers.io puis redirige vers le tenant initialement demandé.

La librairie securesocial, initialement sélectionnée pour nous simplifier la vie, nous met des battons dans les roues. J'ai dû créer une version custom de SecureAction qui rajoute deux lignes pour forcer l'hôte "www" en login, et mémoriser l'URL complète (pas juste l'URI relative au serveur) pour renvoyer l'utilisateur vers la page initialement demandée.

Pour l'instant, j'ai copié/coller du code de securesocial, je pense à plutôt me baser sur un fork, ce qui permettrait de synchroniser les évolutions upstream plus facilement (merci Git).

Bref, la vie n'est pas un long fleuve tranquille :)


23 janvier 2014

Les détails sont dans l'épaisseur du trait

Olivier Croisier a publié un article sur ses expérimentations avec Java 8, plus précisément l'introduction des default methods dans les interfaces. Cette nouveauté dans la syntaxe Java a été introduite initialement pour permettre à l'API Collections d'évoluer sans nécessiter à tout un écosystème de librairie de produire de nouvelles versions mises à jour pour Java 8, autrement dit d'attendre 2020 pour que ce soit utilisable concrètement.

Comme l'a très bien analysé Olivier, ces default methods apportent à Java le concept de trait très utilisé en Scala. La tournure fonctionnelle que Java 8 va permettre de faire prendre au langage est un pas majeur, bien plus important amha que l'introduction des génériques en Java 5.

Pour rebondir sur le problème du diamant exposé par Olivier, mon interrogation sur les conflits de méthodes introduites pas les default methods se pose un peu différemment :

nous avons donc une classe Clazz qui implémente deux interfaces Foo et Bar.

1 public interface Foo {
2     public default void helloWorld() {
3         System.out.println("Hello World");}
4 }

1 public interface Bar {
2 }


1 public class Clazz implements Foo, Bar {
2 
3     public static void main(String args[]) throws Exception {
4         new Main().helloWorld();
5     }
6 }

Disons que la première déclare une default method helloworld(). Si Bar définit lui aussi la même default method le compilateur détecte le conflit. Supposons cependant que dans un premier temps Bar n'a pas de telle méthode et que nous compilons notre projet. Nous ajoutons alors a Bar la default method conflictuelle, et re-compilons la classe Bar (et elle seule).

Question : est-ce que notre programme continue de fonctionner comme avant - en gros, est-ce que le bytecode produit fait directement référence à la méthode Foo.helloworld(). Ce qui veut dire que nous ne pouvons plus le re-compiler depuis les sources. Une bonne raison de configurer votre intégration continue avec un "mvn clean install" :)

Je vous laisse essayer par vous même pour avoir la réponse :-D

Java 8 apporte des changements profonds, et expérimenter est la seule façon concrète de comprendre leur impact. Voir ce que fait Yan sur https://github.com/ybonnel/Jdk8Experiments par exemple, je vous encourage à en faire autant.

Je suis en ce moment (exactement en ce moment, dans le TGV Rennes-Paris, connecté en tethering) en train de lire le livre "Functional Programming for Java Developers". Si le livre n'est pas tout juste sorti des presses et ne parle donc qu'à peine de Java 8, et avec une syntaxe obsolète, les concepts fondamentaux sont bien présents et très utiles.


J'entend beaucoup de monde me dire qu'ils n'utiliseront pas Java 8 avant une décennie, bloqués par les contraintes client d'un runtime websphere 6. C'est évidement une réalité, et clairement vous n'aurez pas de traits dans vos applications. Ca n'empêche pas de commence à appréhender les concepts fonctionnels, qui sont un excellent complément à l'approche objet.

En dehors de l'approche fonctionnel que va (mieux) permettre Java 8, ces changements annoncent aussi des bouleversements dans l'écosystème des librairies et frameworks. Exemple type, de nombres frameworks définissent des classes abstraites, que votre code doit étendre. Un jeu d'interface serait plus propre, mais alors impossible de faire évoluer les API. Jenkins par exemple comporte une quantité phénoménale de classes abstraites pour cette raison.

Autre approche si on aime pas les classes abstraites, faire à la façon d'Eclipse, en définissant des interfaces HelloWorld1, HelloWorld2, HelloWorld3, et en testant au runtime quelle interface est implémentée, bref une solution pire que le mal lui même.

Bref, tous les frameworks pre-java 8 - en dehors d'Eclipse - se basent sur des classes abstraites, et pourrissent nos arbres d'héritage. Une opportunité apparaît donc avec Java 8 pour une nouvelle génération de frameworks, basés sur des traits. Le même genre de changement qui a laissé commons-collections sur le carreau avec l'arrivée des génériques et une mise à niveau jamais aboutie, qui a laissé la place à Guava et quelques autres.

Donc, oui, votre client a du Java 5 en production. Oui, c'est une version "End of Life" mais il s'en fout, et vous n'y pouvez rien. Et pourtant, si vous ne voulez pas passer pour un développeur avec des faux airs de Cobol dans quelques années, il est temps pour vous de regarder ce qu'apporte Java 8, d'expérimenter, de découvrir les bénéfices et les concepts de la programmation fonctionnelle, et de pleurer en revenant à votre code sans lambdas ;)