18 février 2014

Maven est mort ...

vive Maven.

Non, je ne parle pas du projet Apache Maven (ce serait peu scrupuleux de ma part de jouer sur l'ambiguïté et d'écrire un billet de blog avec un titre tapageur) mais du livre Apache Maven, édité par Pearson.

Arnaud et moi avons aujourd'hui reçu ce courrier :


Nous avions été prévenus de l'arrêt de la publication, et avons demandé la restitution de nos droits. Voilà chose qui est donc officielle. Au passage, je m'amuse de voir le livre toujours référencé sur http://www.pearson.fr/livre/?GCOI=27440100730370 et disponible en eBook :P

Bon bref, cette expérience d'édition a été instructive :

  • le travail sous Word avec un template barbare est une horreur
  • le processus de relecture et de PAO est une horreur
  • ça prend un temps fou
  • ça rapport très peu par rapport aux heures consacrées
Nous avons donc décidé de diffuser le contenu librement, après conversion au format AsciiDoc. La conversion étant loin d'être parfaire il reste pas mal de couacs, en plus de ceux présents dans le texte lui même, mais globalement, vous pouvez à présent nous lire de manière totalement gratuite et libre (license CC BY-SA).

https://github.com/ndeloof/apache-maven-book

Si vous voulez nous aider à faire vivre ce livre, vos contributions sont les bienvenues. Sinon il finira de mourir tranquillement en attendant que Maven 4.0 voie le jour. Et si vous regrettez l'époque où vous pouviez nous rémunérer pour ce travail (1,23€ par vente, imposable), nous sommes à votre disposition pour une bière ;-)

28 janvier 2014

Jouons un peu avec securesocial

L'équipe du BreizhCamp est en train de dépoussiérer l'appli Call-for-Papers développée l'an dernier. L'objectif premier est bien sur l'ouverture prochaine du CFP 2014, mais aussi l'hébergement à moyen termes d'un Call-for-Paper "as-a-Service", opensource et gratuit pour les tous les organisateurs de conférences. 

L'idée vient évidemment de ce que je bosse chez CloudBees (ce qui nous permet d'avoir des tarifs d'hébergement imbattables !) et que le développement d'un SaaS multi-tenant est un sujet qui m'intéresse énormément. 

L'idée vient aussi de ce que je suis moi-même speaker, et que j'en ai marre de copier/coller ma bio d'un CFP à l'autre. Avec un seul service sur lequel j'aurais mon profil, je pourrais postuler plus confortablement :)

Bref, ménage de printemps dans le code, qui est fonctionnel mais ... mérite quelques améliorations :) En gros, l'appli a été finalisée l'an dernier PENDANT le call-for-papers, il y avait donc pas mal de trucs plus ou moins bien finis.


L'appli est en Play2 / Java (l'équipe n'est pas très friande de code Scala) et l'UI en AngularJS. Nous avons donc naturellement confié l'authentification à la librairie SecureSocial. Vous pouvez donc vous identifier via les services OAuth github, google, etc.

OAuth

OAuth est un protocole d'authentification qui permet de fournir à une appli l'accès à vos données hébergées par une autre appli, sans pour autant lui donner votre mot de passe. L'application "cliente" vous renvoie vers l'applicable "cible", qui affiche une demande de confirmation, indiquant les droits demandés. Un callback fournit alors à l'application cliente un token pour accéder aux infos demanders. 

La sécurité d'OAuth est basée sur l'enregistrement de l'appli cliente chez le fournisseur de données.Le client dispose un ID+Secret unique qu'il utilise pour demander au fournisseur l'accès aux données - fournisseur qui demande l'autorisation de l'utilisateur - avant d'appeler le callback redirect_url.  


Je ne vais pas vous détailler plus OAuth, complètement pris en charge par securesocial, ce qu'il faut retenir c'est cette redirect_url vers laquelle vous ramène le provider après confirmation de l'accès. Ce callback doit être sur le domaine prévu, ce qui évite une utilisation frauduleuse, en complément de l'ID+Secret.

SecureSocial

SecureSocial est une libraire bien pensée, offrant des API Scala et Java, ce qui nous arrange bien :)

Un problème qui avait émergé dès l'an dernier, est que securesocial nous fournit comme identifiant d'utilisateur l'ID défini par le provider OAuth. Cela veut dire que Jean Dupont identifié par github n'est pas la même personne que Jean Dupont identifié par google. Par ailleurs, l'API de twitter ne permet pas d'obtenir l'email de l'utilisateur - et c'est volontaire

Première évolution, l'email devient la clé d'un utilisateur, ce qui autorise l'identification multi provider, et bien sur Twitter passe à la trappe (nous pourrions le rétablir, sous réserver d'obliger l'utilisateur à saisir son email et à le confirmer ... bref ce n'est pas du tout indispensable).

Seconde évolution, j'ai ajouté l'authentification via linkedin. J'ai galéré un moment, avant de comprendre que le provider OpenSocial ne prend pas le scope email chargé de demander l'email utilisateur. J'ai donc du définir ma propre implémentation, l'occasion aussi de remettre un peu le nez dans du Scala, j'aime bien de temps en temps, ça me change de Jenkins...

Détail amusant (?), l'implem' OAuth de LinkedIn ne contrôle pas du tout le domaine utilisé par la redirect_url, ce qui permet de tester même depuis localhost:9000 - de là à se demander si c'est très sécurisé tout ça ...

Troisième évolution, dans le but de faire de notre Call-for-Papers un SaaS, il faut gérer des sous-domaines (breizhcamp.call-for-papers.io, javaone.call-for-papers.io, etc). Vous voyez rapidement le problème, chaque conférence ayant un domaine propre, il faudrait un ID+Secret différent sur chaque provider OAuth. L'idée est donc que la page de login soit sur www.call-for-papers.io puis redirige vers le tenant initialement demandé.

La librairie securesocial, initialement sélectionnée pour nous simplifier la vie, nous met des battons dans les roues. J'ai dû créer une version custom de SecureAction qui rajoute deux lignes pour forcer l'hôte "www" en login, et mémoriser l'URL complète (pas juste l'URI relative au serveur) pour renvoyer l'utilisateur vers la page initialement demandée.

Pour l'instant, j'ai copié/coller du code de securesocial, je pense à plutôt me baser sur un fork, ce qui permettrait de synchroniser les évolutions upstream plus facilement (merci Git).

Bref, la vie n'est pas un long fleuve tranquille :)


23 janvier 2014

Les détails sont dans l'épaisseur du trait

Olivier Croisier a publié un article sur ses expérimentations avec Java 8, plus précisément l'introduction des default methods dans les interfaces. Cette nouveauté dans la syntaxe Java a été introduite initialement pour permettre à l'API Collections d'évoluer sans nécessiter à tout un écosystème de librairie de produire de nouvelles versions mises à jour pour Java 8, autrement dit d'attendre 2020 pour que ce soit utilisable concrètement.

Comme l'a très bien analysé Olivier, ces default methods apportent à Java le concept de trait très utilisé en Scala. La tournure fonctionnelle que Java 8 va permettre de faire prendre au langage est un pas majeur, bien plus important amha que l'introduction des génériques en Java 5.

Pour rebondir sur le problème du diamant exposé par Olivier, mon interrogation sur les conflits de méthodes introduites pas les default methods se pose un peu différemment :

nous avons donc une classe Clazz qui implémente deux interfaces Foo et Bar.

1 public interface Foo {
2     public default void helloWorld() {
3         System.out.println("Hello World");}
4 }

1 public interface Bar {
2 }


1 public class Clazz implements Foo, Bar {
2 
3     public static void main(String args[]) throws Exception {
4         new Main().helloWorld();
5     }
6 }

Disons que la première déclare une default method helloworld(). Si Bar définit lui aussi la même default method le compilateur détecte le conflit. Supposons cependant que dans un premier temps Bar n'a pas de telle méthode et que nous compilons notre projet. Nous ajoutons alors a Bar la default method conflictuelle, et re-compilons la classe Bar (et elle seule).

Question : est-ce que notre programme continue de fonctionner comme avant - en gros, est-ce que le bytecode produit fait directement référence à la méthode Foo.helloworld(). Ce qui veut dire que nous ne pouvons plus le re-compiler depuis les sources. Une bonne raison de configurer votre intégration continue avec un "mvn clean install" :)

Je vous laisse essayer par vous même pour avoir la réponse :-D

Java 8 apporte des changements profonds, et expérimenter est la seule façon concrète de comprendre leur impact. Voir ce que fait Yan sur https://github.com/ybonnel/Jdk8Experiments par exemple, je vous encourage à en faire autant.

Je suis en ce moment (exactement en ce moment, dans le TGV Rennes-Paris, connecté en tethering) en train de lire le livre "Functional Programming for Java Developers". Si le livre n'est pas tout juste sorti des presses et ne parle donc qu'à peine de Java 8, et avec une syntaxe obsolète, les concepts fondamentaux sont bien présents et très utiles.


J'entend beaucoup de monde me dire qu'ils n'utiliseront pas Java 8 avant une décennie, bloqués par les contraintes client d'un runtime websphere 6. C'est évidement une réalité, et clairement vous n'aurez pas de traits dans vos applications. Ca n'empêche pas de commence à appréhender les concepts fonctionnels, qui sont un excellent complément à l'approche objet.

En dehors de l'approche fonctionnel que va (mieux) permettre Java 8, ces changements annoncent aussi des bouleversements dans l'écosystème des librairies et frameworks. Exemple type, de nombres frameworks définissent des classes abstraites, que votre code doit étendre. Un jeu d'interface serait plus propre, mais alors impossible de faire évoluer les API. Jenkins par exemple comporte une quantité phénoménale de classes abstraites pour cette raison.

Autre approche si on aime pas les classes abstraites, faire à la façon d'Eclipse, en définissant des interfaces HelloWorld1, HelloWorld2, HelloWorld3, et en testant au runtime quelle interface est implémentée, bref une solution pire que le mal lui même.

Bref, tous les frameworks pre-java 8 - en dehors d'Eclipse - se basent sur des classes abstraites, et pourrissent nos arbres d'héritage. Une opportunité apparaît donc avec Java 8 pour une nouvelle génération de frameworks, basés sur des traits. Le même genre de changement qui a laissé commons-collections sur le carreau avec l'arrivée des génériques et une mise à niveau jamais aboutie, qui a laissé la place à Guava et quelques autres.

Donc, oui, votre client a du Java 5 en production. Oui, c'est une version "End of Life" mais il s'en fout, et vous n'y pouvez rien. Et pourtant, si vous ne voulez pas passer pour un développeur avec des faux airs de Cobol dans quelques années, il est temps pour vous de regarder ce qu'apporte Java 8, d'expérimenter, de découvrir les bénéfices et les concepts de la programmation fonctionnelle, et de pleurer en revenant à votre code sans lambdas ;)

13 janvier 2014

BootCamp Rennes DevOps

Même si on atteint pas la prolifération de S*UG (Scala | Scrum | Spring | ... | user-groups) qu'offre la capitale, Rennes n'est pas en reste d'activité communautaire. Il y a bien sur le BreizhJUG, devenu au fil du temps une institution locale, mais aussi de plus petit groupes plein de bonnes idées, comme par exemple Rennes Devops.

Avec la possible venue d'OVH dans la capitale Bretonne, le groupe veut démontrer son dynamisme, et organise le 25 janvier un BootCamp DevOps à la Cantine Numérique Rennaise.


Pour ma part, j'ai proposé d'y parler un peu de déploiement continu avec Jenkins, mais surtout de Docker. Donc si vous voulez passer un bon moment et élargir un peu vos horizon d'architecte Java EE, bloquez votre agenda !

Interview de Nicolas Ledez, initiateur du BootCamp :


Bonjour Nicolas, est-ce que tu peux te présenter en quelques mots ? 

Bonjour Nicolas, je suis un "hacker" Ruby, DevOps, Admin Système, Arduino, etc. Je bidouille depuis tout petit, électronique, informatique. Coup de bol, j'ai réussi à en faire mon metier.

Est-ce que tu peux nous expliquer le concept de "BootCamp" ? 

Je vois ça comme la possibilité d'aider les gens à réussir leurs bonnes résolutions de début d'année. Aux US c'est du sport. Mais comme il fait encore un peu froid en Bretagne, je propose de commencer l'année en démarrant avec des technos comme Docker, le Cloud, Chef et plein de trucs DevOps. 

Qu'est ce qui t'es passé par la tête pour lancer ce projet ? Trop de temps libre ? 

À l'origine, c'était une idée de Frédéric Alix (http://blog.fredalix.com). Qui pour différentes raisons n'a pas pu y donner suite. Et finalement, pour les développeurs, il y a l'excellent Breizhcamp, mais rien pour les ops - donc…

Et j'ai aussi un petit coté maso :p

Tu enseigne aussi la robotique sur Lego NXT ! As tu encore beaucoup d'autres  cordes cachées à ton arc ? 


Hou là !!! Oui beaucoup.
Je vais démarrer des cours pour débutant de développement Web dans le cadre du http://labfab.fr/
+ Breizhcamp, Devcamp, et plein d'autre trucs 

ok, rendez vous le 25 pour te voir à l'oeuvre 

infos et inscriptions : http://rennesdevops.fr/bootcamp-rennes-devops/

13 décembre 2013

Rendez-vous à Devoxx France

Devoxx France a ouvert son Call for Paper début décembre, et se pose pour moi la question de quoi proposer.

L'an dernier j'ai mis tout ce que j'avais en magasin, au risque de passer pour un spam-bot. J'ai constaté que les sujets "cloud" ou "continuous delivery" qui me sont chers ne font pas rêver le comité de sélection - ou alors je ne suis pas bon vendeur.

Bref, suivant une suggestion de Nico Martignole, je lance un Google Moderator :

Quel sujet voudriez-vous me voir présenter à Devoxx 2014

A vous de jouer !

19 novembre 2013

être speaker à Devoxx

Devoxx a toujours été pour moi LA conférence. Les locaux inégalables, l'ambiance bon-enfant, la diversité et la fréquentation en font un événement sans équivalent.

J'ai présenté ma conférence "Cloud Patterns" pour la première fois à Mix-IT, ce qui m'a permis d'en caller la durée. J'ai pu l'expérimenter en version EN_fr à GeeCon, la re-jouer à SoftShake et CodeurEnSeine et en peaufiner les détails. J'ai eu le temps de me faire à Keynote pour agrémenter mes slides d'effets graphiques sympas. Bref, c'est un talk rodé.

J'ai été retenu à JavaOne. Très franchement, après l'expérience GeeCon je n'étais pas spécialement stressé de faire ce talk devant le public américain. JavaOne c'est beaucoup de monde mais surtout beaucoup de petites salles. Et comme j'étais prévu en dernier slot la question était plutôt de savoir si je serais tout seul dans la salle...

Et il y a eu Devoxx.

Mon talk a été retenu, et c'est une grande fierté. Et malgré le rodage préalable, faire cette conf à Devoxx a suscité un trac important. Je ne saurais pas dire précisément ce que cette conférence à de si particulier, mais elle est clairement à part.

D'une part, il n'y a pas de "speaker room" et c'est volontaire : les organisateurs désirent que les speakers se mélangent à la foule et soient accessibles. De grandes tables permettent aux geeks en tout genre de bosser/hacker entre deux sessions, beaucoup de speakers en profitent et sont ainsi disponibles pour des questions complémentaires. Bref, un speaker à Devoxx est un Devoxian comme les autres

Il n'y a pas de "petite salle". Si on met de côté les deux salles des BOFs, les immenses salles de cinéma du Métropolis accueillent de 400 à 800 personnes. Evidemment on est pas sur qu'elles soient pleines, mais ça fait un effet non négligeable sur le speaker tout seul en bas.

Il ya les copains. Devoxx c'est à 2h de Paris et les Français y sont nombreux. On en repère un ou deux dans la salle malgré les projecteurs en plein tronche et ça aide bien moralement.

Il y a Stephan et toute l'équipe Devoxx, ultra disponibles à toute heure. Stephan a eu la gentillesse de venir me dire un mot juste avant mon talk - en fait deux : "bonne chance" et "évite les photos compromettantes". J'ai presque tenu compte de ses conseils.

Bref, être à Devoxx comme speaker, c'est quelque chose de spécial. C'est à la fois se sentir comme à la maison et dans la plus prestigieuse conférence de l'univers. De quoi se sentir à l'aise pour donner son maximum.


09 novembre 2013

on est pourtant pas vendredi 13

J'enchaine les coups de stress ces temps ci

la semaine dernière, en plein pendant un week-end dans la famille, mon Galaxy S3 me fait le coup de la "mort subite". J'ai retiré 25 fois la batterie, épluché les forums ... en vain.


Bon, allez, y'a pas mort d'homme, et en plus voilà un prétexte tout trouvé pour commander le Nexus 5.

Lundi, allez hop soyons fou je migre mon MacBook sous Maverick. "upgrade gratuit" de la part d'Apple, j'aurais de me méfier. Aucun changement notable.

petite parenthèse : j'essaye "plan" vite fait, dont j'ai entendu tant de mal, et la photo aérienne de mon chez-moi est plus à jour et de bien meilleure qualité que google maps. Donc pour un gars qui vit dans sa campagne comme moi c'est plutôt positif ;)


Après l'ugrade, mon code d'accès à https (je bosse sur le plugin git jenkins) se met à planter - j'apprends qu'il faut réinstaller le java 6 Apple.

Bon, allez, y'a pas mort d'homme, c'est pas méchant ça m'a "juste" fait perdre une journée de taf, c'est pas comme si j'était grave à la bourre juste avant Devoxx.

Sinon R.A.S, ça reste un OSX quasiment tout pareil - ça m'aurait fait mal de payer un upgrade pour ça - jusqu'à ce que je décide de rebooter (quand git n'arrive plus à résoudre "github.com", c'est pas bon), après tout un reboot une fois par semestre ça peut pas faire de mal.

Et là, gros coup de stress : mot de passe refusé.


Donc chez Apple, ils ont décidé que maintenant, le clavier au démarrage serait en QWERTY, voilà comme ça. Il y a une icône à peine visible pour l'indiquer. C'est pas comme si l'avantage concurrentiel d'apple c'est de maitriser le hardware, donc on pourrait s'attendre à ce que l'OS sache quel variante du clavier est intégrée au MacBook. 

Bon, allez, y'a pas mort d'homme, j'ai juste appris quelques injures à mes gamins et pris 2 points de tension, en plus ça me rappelle de faire une sauvegarde time-machine.

quelques heures après, juste le temps de se détendre un peu (sic) je reçois un coup de fil sur mon nexus 5 tout neuf - un appel automatique du monitoring CloudBees - je raccroche, et j'ai un écran noir. Le téléphone ne répond plus à aucune touche (moralité, il ne faut pas répondre aux appels d'alerte du monitoring).

Panique à bord, avec un ++ vu que je n'ai même pas encore annoncé à Madame que j'ai acheté ce nouveau jouet. Twitter est ton amis et j'apprend donc à utiliser le power + volume bas (10 secondes) pour un reboot forcé.


A ce stade le week-end ne fait que commencer, mais j'ai mon compte. Je dois encore finir de préparer mes slides pour Devoxx, j'espère qu'on va en rester là.


Bon, allez, y'a pas mort d'homme. 

Mais vous savez à quelle point un Geek est dépendant de son attirail high-tech...


31 octobre 2013

Git sucks

Titre tapageur - serais-je un peu provocateur ?


Non, je ne vais pas faire l'apologie de Clearcase, je suis très content de Git en tant que développeur et je n'ai absolument pas l'intention de changer, même pour un autre DVCS.

Par contre, je suis mainteneur du plugin Git pour jenkins. J'ai hérité de ce plugin sans trop savoir comment, au départ en backportant des correctifs utilisés par CloudBees puis rapidement faute d'une mainteneur en place. Et j'ai rapidement compris pourquoi : ce plugin est un amalgame de pull-requests en tout genre.

Le problème de la pull-request, c'est


  1. quand on crée un patch, et donc une pull-request, on essaie de faire minimaliste. On ne fait pas un gros refactoring juste pour la beauté du geste. On va donc ajouter un "if (foo) { ... } else" dans le code existant. 25 pull requests plus tard la méthode fait 400 lignes et est incompréhensible.
  2. si c'est un mécanisme de revue de code formidable, en opensource la pull-request a ce désagréable effet de bord de permettre à un contributeur de "balancer" du code par dessus le mur, sans s'impliquer forcément dans le projet. D'où l'absence de continuté sur ce plugin.

Bon, ça c'est l'historique, qui n'aide pas, mais pas le coeur du problème.

L'un des principaux objectifs pour la version 2.0 du plugin Git était d'introduire le support de l'authentification via le plugin credentials.

L'option 1, c'était JGit. Il y a quelques temps le plugin Subversion est passé à svnkit plutôt que de piloter le client svn pour des raisons comparables. JGit prométait de faire de même. Sauf que JGit est encore loin du niveau de maturité nécessaire pour être utilisé dans le plugin jenkins. J'ai rapidement découvert la ... créativité des développeurs dans leur usage de Git, et le manque de documentation de JGit, ainsi que l'absence de fonctionnalités pourtant pas mineures. Quand je pense que les utilisateurs d'Eclipse se basent dessus j'ai un peu peur...

JGit reste donc une option expérimentale, et ça risque d'être le cas encore un bon moment.


L'option 2, c'était de conserver le pilotage de la ligne de commande git. Plusieurs problèmes majeurs, et c'est ce qui me fait dire que "Git - i.e., le client git en ligne de commande - sucks"

  1. le client git n'a pas de mode non-interactif. Il peut donc bloquer en demandant à l'utilisateur son username, ce qui bloque jenkins par la même occasion. Je ne connais pas d'outil en ligne de commande qui n'ai pas une option "batch", "quiet" ou "force", bref un truc prévu justement pour ce genre de cas de figure où il n'y a PAS d'utilisateur en face de la console.
  2. le client git ne fournit AUCUN moyen de passer les paramètres d'authentification. En http il se base éventuellement sur .netrc (un fichier prévu pour ftp soit dit en passant), et en ssh il se base sur le client ssh et vous laisse dans la m... StackOverflow regorge de hacks divers pour contourner ces problèmes, et même la doc officielle s'en lave les mains et vous dit de bricoler un script shell. 
To pass options to the program that you want to list in GIT_SSH you will need to wrap the program and options into a shell script, then set GIT_SSH to refer to the shell script.


Ce qui, bien évidement, ne fonctionne que sur un système Unix-like (JENKINS-20356)


Je cherche toujours l'option 3. Il n'existe à ma connaissance pas d'autre client Git que je pourrais utiliser depuis du code Java (des suggestions ?).


Update:
Certains sont surpris. Après tout JGit est utilisé par EGit, mais aussi Gerrit, ou GitBlit; alors quoi, peut être que le plugin jenkins est juste codé avec les pieds - ce qui n'est pas faux mais bon je m'égare.
Je viens d'apprendre que le plugin git maven lui aussi souffre des limitations de JGit. Entre autre des file leaks sous windows, problème rapporté par de nombreux utilisateurs de git-plugin. 

De mon côté je lorgne sur libgit2, qui permettrait d'utiliser un client git natif. Mais évidemment il n'existe pas de binding Java :'(


18 octobre 2013

Configuration Management JSR

I recently discovered project to start a JSR for Configuration Management. Mike Keith introduced this project at JavaOne, you can download slides for his presentation here. I wasn't aware so didn't attend the live talk, but reviewing the slides I have few comments.

Proposal (afaik)

Scope for such a JSR is difficult to establish. If you want to embrace the existing tools, there is overlap with generic platform provisioning. I don't think this is a good idea to consider this until there's a reasonable consensus on application-level configuration management. Looks like this is also the diagnostic for this JSR.

The current state for JavaEE configuration is "JNDI" : if you need to inject some resources / parameter to an application, you have to provide some container-specific xml file in your WAR archive. This suppose Ops will unzip the WAR, edit xml to put production resource binding and credentials, then re-archive and deploy using container-specific commands. Nobody never did this. So this is a great idea to review this and provide something to better match actual practices and tools.

Also have to consider the DevOps impact on development/deployment practices.

Contract for configuration management is also complex to establish. Reviewing slides, the proposal seems to be to package application configuration in a CAR (configuration archive).


I think this is a very bad idea. For the same reason Ops don't unzip WAR to edit xml files, they won't do this to create CAR files. Ops tools and practices are based on scriptable solutions from system shell. I don't think we will see JavaEE apps packaged as RPM/DEB system packages, at least because Java is supposed to "run everywhere", not just on Linux distros. But a configuration management JSR must primarily focus on Ops practices, not on JavaEE developers. JSR use to define Java based API, I think this specific JSR must NOT use Java as primary language. My main concern with a java-based approach is that this will result in a new java.util.prefs.Preferences nobody is using.


My vision

I'd prefer the JSR to define a REST API application container (or platform as a service) have to expose to allow defining the configuration for an application. REST is neutral, well supported both from Java tooling and base script shell (using curl).

So, you can imagine a REST endpoint on your application server that let you define an "application" (unique ID) and bind server resources / configuration parameters to this application. Application server is responsible to implement actual persistence.

Deploying an application would then be :


  1. create the application with unique ID
  2. set application configuration 
    • resource bindings (JDBC DataSource, JavaMail session, JMS queues, etc)
    • simple parameters
    • structured parameters (? - see later)
  3. deploy WAR/EAR for application ID


Application configuration has to be persistent : it will survive application restart and redeployment, as long as application unique ID is unchanged. It's also idempotent: binding same resource twice don't result in a duplicated resource. This is a requirement for infrastructure automation tools (like Chef/Puppet) to work in this context.

Without any surprise, you probably notice how this proposal mimic CloudBees configuration management. We also support cloudbees-web.xml and some of us like it, but I consider this legacy. Using SDK to bind a Database to my application, whatever application server I'm using - Tomcat, JBoss, Glassfish, Jetty - and getting it injected as a JNDI DataSource is awesome.


How does application access configuration ?

Based on slides, JSR proposal defines a new API for application code to access configuration. So, you'll have to wait for all frameworks to be updated to benefit this API :-/

To workaround design issue for JavaEE to miss a configuration API, most framework rely on placeholders, the common denominator being support for system properties. I never have seen a JavaEE application to use String declared in JNDI, but I not a bunch of apps to get runtime settings from system properties. For adoption of a configuration management JSR, and immediate support on most frameworks, system properties must be considered as first-class citizens in configuration land.

Injecting a simple parameter in an application should result in getting the equivalent system property set. With system properties, you already can manage a bunch of use-cases. I'm not sure there's actual need for structured parameters. This could be addressed by JAXB / JSONB data binding anyway.

Conclusion

I'd be very happy to contribute this JSR. I've been looking for an "incubator" page for it but can't find this on jcp.org. I'm not sure then how expert group is established, but if I can join I'd be very happy to compare my point of view with others and help as much as possible to make this JSR a useful one.


29 septembre 2013

private, public, hybrid

Après mon talk "Cloud Patterns"et comme presque à chaque fois j'ai eu droit à des réactions étonnées sur ma position (ie. celle de CloudBees) sur l'approche "Private Cloud". Explications:

photo credit: Cici D


disclaimer: Je Bosse chez CloudBees. Je partage l'analyse de ma société, cependant libre à vous de considérer que je suis biaisé dans ma perception des choses.

1. Cloud != DataCenter

Première confusion, de nombreuses sociétés parlent de "Cloud Privé" pour le DataCenter dans lequel elles sont en train de mettre en place de la virtualisation. Soyons clair, je définit un "Cloud" comme :

  • ressources (quasi) illimitées, disponibles à la demande - ce qui ne veut pas dire sans quotas ni restrictions,
  • accès direct par API, sans passage par la case "formulaire bleu à envoyer à l'admin signé par le CdP",
  • mutualisation des ressources et facturation à l'usage,
  • délégation complète de la maintenance et du support.

De ce point de vue, nombreux sont les projets de "Cloud privé" qui sont en fait des migrations d'une IT basée sur du hardware dédié vers des solutions de type IaaS à la main. Je n'insisterais pas, mais lorsque je parle de Cloud je parle clairement de Plateforme as a Service.

le "Cloud" vu par de nombreuses sociétés en pleine mutation


Le dernier point, "délégation complète de la maintenance et du support", cher à CloudBees comme à Google AppEngine, est ce qui nous différencie de CloudFoundry et OpenShift. Nous considérons qu'il est la clé du concept même de Cloud, au delà de la virtualisation complète des ressources.

Mettre en place votre infra OpenStack est passionnant pour l'ingénierie, mais couteux en termes de formation des équipes de maintenance (voir ce témoignage). OpenStack ou autre est loin, très loin d'être une solution triviale, et s'assurer que l'hyperviseur est compatible et sera maintenu sur votre infra physique est une gageure. C'est d'ailleurs un nouveau marché pour les HP et autres Dell, de proposer du hardware labellisé pour ces usages.

La force d'amazon EC2 est justement le contrôle complet du hardware sur lequel tourne l'IaaS. La standardisation est la clé de la réduction de coût à grande échelle. Elle permet de monter rapidement de nouveaux services ou de blinder ceux qui existent, là ou des solutions ouvertes, malgré leur qualités indiscutables, s'imposent un gigantesque effort de suivi.

un exemple de standardisation : le hardware des datacenter Facebook

2. Private != Service

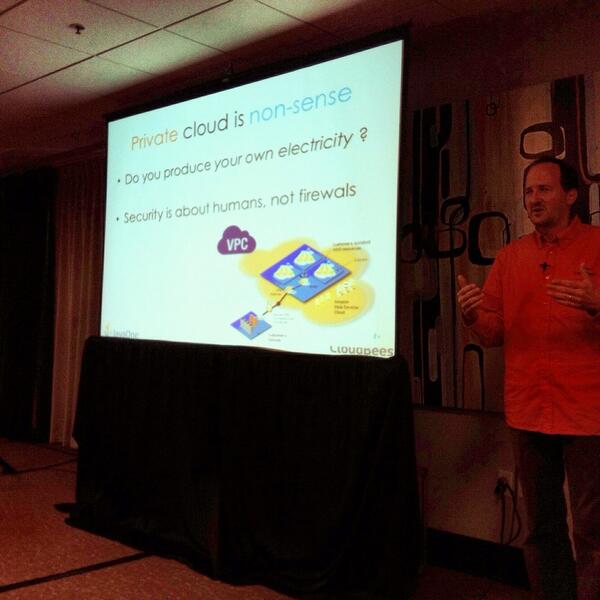
Installer la solution "private" de CloudPoireaux sur votre infra, c'est installer un soft; c'est du Platform-as-a-Software. C'est disposer d'une équipe infra à la hauteur. Nous avons l'habitude chez CloudBees de demander "produisez-vous votre propre électricité ?". Il y a un siècle, c'était le cas dans pas mal de grosses entreprises, avant que les tensions et la distribution se standardise et que la production ce concentre dans des usines spécialisées. L'informatique vit la même évolution. L'OS standard est un Linux sur architecture x86. L'étape qui suit est la concentration.

On évoque souvent des contraintes de sécurité. Ne croyez pas que CloudBees n'ait comme client que des start-ups, et que les banques et assurances nous boudent. 

La sécurité est un problème technique parfaitement géré. Le lancement d'Amazon Virtual Private Cloud est un signe: les clients d'Amazon sont de grosses, voir très grosses entités, qui déportent partiellement leur infra sur EC2. VPC leur assure une isolation techniquement sans appel.

amazon VPC : un bout de cloud dans votre réseau privé


Il reste ensuite le problème politique pour la direction IT de lâcher son emprise sur l'infra et évoluer vers un métier de niveau supérieur - le Cloud ne vous privant pas de boulot, avec d'intéressants challenges d'intégration de services. Problème de transformation interne que je vous laisse traiter :D

L'argument clé que nous avons chez CloudBees pour nos clients sceptiques c'est la mobilité. Certains de nos clients développent ainsi des applications mobiles pour leurs équipes sur le terrain. De fait, les données transitent déjà sur le réseau public. Le problème de la sécurité a donc forcément déjà été traité, reste à l'appliquer de manière plus globale. Amusant aussi de voire que ces mêmes entreprises ont leurs données client, données hautement stratégiques s'il en est, hébergées sur SalesForce, sans parler du commercial Microsoft qui se prépare à leur vendre du Office 365. De la politique donc.

3. Public Cloud + Private data = Hybrid 

L'hybridation private/public est une piste très prometteuse. En effet, le réel frein à la migration d'une société vers le Cloud est son coeur de métier, sa base d'information Oracle / SAP hébergée en interne et souvent volumineuse. Ces données ne migreront pas vers le Cloud, car cela impacterait trop d'applications legacy et le transfert de données auxquelles le SI accède en continu est délicat. 

Migrer un tel existant est à la fois techniquement et politiquement complexe. Inutile de commencer pas le plus difficile lorsqu'il existe des solutions simples et fiables de contournement.

L'hybridation entre des applications sur Cloud public, bénéficiant d'une plateforme standardisée, supportée, et élastique, couplée aux données privées via VPC/VPN, permet de mettre en place des solutions très élégantes avec un cycle de développement extrêmement court. 


un zorse (zébrule en bon français), hybride zèbre/jument à l'élégance rare :P

CloudBees propose depuis 2011 une solution hybride inverse, à savoir installer la base technique CloudBees sur votre IaaS privé (VMWare, OpenStack) tout en conservant le pilotage depuis le Cloud public cloudbees.com. Cette approche "AnyCloud" n'a pas révolutionné la donne à ce jour, entre autre parce qu'elle impose de disposer d'une équipe IaaS privée qui réduit sensiblement les bénéfices du Cloud, et qu'il manque alors à vos applications tout l'écosystème de service qui, eux, restent sur Amazon.

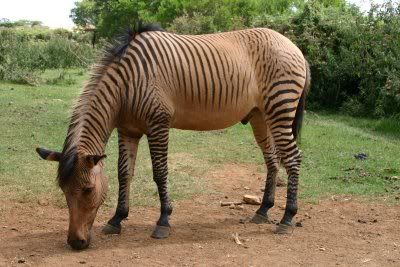
un zonkey (zébrâne), autre hybride sympathique


N'hésitez pas à me toper à l'occasion d'une conférence si vous voulez en discuter :)


18 septembre 2013

Write a Book

J'ai écrit deux bouquins (enfin trois, ça dépend comment on compte)

Le premier, Apache Maven pour Pearson, a été mon premier pas dans le monde de l'édition. J'ai découvert le template word imposé par l'éditeur, le long travail de marquage du texte pour générer l'index. Bref, la rédaction n'est qu'une petite partie du travail au final. Nous (Arnaud et moi, co-auteurs) travaillions avec un partage Dropbox, ce qui a permis d'aller assez vite dans la mise au point du contenu. Le travail a été très supérieur à ce que j'estimais, aussi - au vue du gain financier - il est clair qu'on fait ce genre d'exercice pour la gloire, pas pour la fortune.

Nous n'avions qu'un seul interlocuteur, ça c'est donc suffisamment bien passé pour que nous plongions une seconde fois. Cette seconde édition a eu lieu pendant un jeu de chaise musicales chez Pearson et donc un manque de suivi assez désastreux. Bref, la seconde édition est sortie sans aucune intention de faire un v3 - encore faudrait-il qu'il y ai de quoi d'ailleurs vu le contenu des nouveautés de Maven 3.1, mais c'est un autre débat.

Je me suis lancé dans un autre livre, plus court et en Anglais, pour Packt. Il s'agit d'un livre sur CloudBees, guide du développeur, donc en plein dans mon sujet. Packt ne m'épargne pas le template maison, bien pire que celui déjà lourd de Pearson. J'en pleure encore. Je suis secondé d'un relecteur non technique chargé de valider mon english pas très fluent et de corriger la mise en forme. Il a tenté de m'expliquer 10 fois les règles fort intéressantes de formatage des textes, mais j'ai autre chose à faire donc je lui ai laissé le plaisir de le faire pour moi - après tout, lui est salarié de Packt, moi je fais ça sur le temps libre que j'arrive à trouver.

La revue des chapitres est sensée se faire par échange de mails. Bienvenu en 2013. J'ai pu imposer un dropbox, surtout que les relecteurs techniques sont sans surprise mes collègues de CloudBees. Ca limite les dégâts, mais au final je passe quelques heures à approuver des changements de style dans le doc.


Accessoirement, Packt impose un planning ultra serré, un chapitre par semaine, je suis donc à 8 semaines de dépassement :P Ils m'ont aussi envoyé de nombreux formulaires word pour indiquer mes coordonnées, ma bio, mes références, et dernièrement un document "très urgent" visant à fournir au marketing des phrases type pour faire la promo du livre. Super, après avoir fait le boulot de la PAO, voilà que je dois faire celui du marketing. A ce rythme ils vont me demander de livrer les bouquins moi-même.

Bref, je ne suis pas prêt de replonger, et je vous déconseille l'expérience si vous êtes tenté de faire connaitre votre projet open-source ou de mettre en avant votre expertise. Pour le gains financier ridicule par rapport au travail, préférez une doc en markdown ou n'importe quel autre format léger, avec un bon script d'export PDF et auto-publiez-vous. Un exemple parfait amha est le livre Pro Git, hébergé sur GitHub  ce qui n'a pas empêché APress de le publier.

08 août 2013

Deux plugins pour le prix d'un

J'ai enfin trouvé le temps de publier la première release du plugin Jenkins "build graph view". Ce plugin permet de visualiser de manière graphique les builds impliqués par un build initial. La mise en place d'un workflow complexe sur Jenkins implique en effet souvent de distribuer le travail dans plusieurs jobs, liés les uns aux autre par des relations "upstream-downstream" orchestrées par une série de plugins.

Le plugin build-pipeline existe déjà sur ce créneau et est très populaire, mais se limite à des exécutions statiques, comprenez que les jobs impliqués sont toujours les mêmes à chaque exécution.
Dans de nombreux cas, cet ordre peut évoluer, certains jobs étant lancés de manière conditionnelle, et on peut aboutir à des chemins d'exécution complètement différents. Build Graph View plugin aborde donc le problème en proposant un graphe dédié à chaque exécution :
Ce n'est "qu'une" 1.0, ce qui signifie que de nombreux liens entre builds ne sont pas supportés à ce stade (plugin join, copy-artifact, promoted builds...). Cependant elle couvre déjà pas mal de cas, et le plugin est facilement extensible, contributions are welcome ;)


Le code de ce plugin est issue d'un autre de mes plugin, le build-flow. Ayant enfin pu finaliser l'extraction dans un plugin dédié, en ajouté les bouts de code qui assurent la complémentarité entre ces deux plugins, j'enchaine avec la release 0.10 de celui-ci. Build Flow va dans le même sens, en constatant que définir un workflow complexe dans Jenkins est bien compliqué, à base de plugins en tout genre pour gérer le passage de paramètres, l'exécution concurrente, etc. L'orchestration des jobs est donc confiée à un DSL, chargé de lancer les jobs. On a ainsi une séparation entre les tâches élémentaires et le wrokflow de plus haut niveau, sans que ce dernier soit dispatché un peu partout et difficile à gérer.

Rien de fondamentalement nouveau dans cette release, désolé pour ceux qui espéraient de grand changements, et surtout pour ceux qui espéraient que cette version soit une 1.0, car on en est pas là ... Ce qui manque au build flow ?

  • Un sandboxing du DSL groovy. En effet, les droits "RUN_SCRIPT" (administrateur) sont nécessaire pour éditer le DSL, sans quoi un utilisateur standard pourrait accéder aux API Jenkins et à la JVM sans contrôle ... ce qui rend le plugin assez inutilisable dans un contexte d'entreprise avec un Jenkins mutualisé. A part un SecurityManager bien trempé je ne vois pas de solution viable pour le moment
    =>  JENKINS-16980.

  • L'exécution asynchrone du DSL. Actuellement, le DSL est lancé comme un simple script, et de ce fait ne peut être interrompu ou relancé. Groovy ne propose pas de "Continuations" qui permettraient de capturer la call-stack pour la relance plus tard. La piste que j'envisage pour le moment est de rendre le script "rejouable" à volonté, les étapes déjà exécutées se transformant alors en NOP. Autre solution pas triviale, utiliser les AST Transformation pour convertir le script impératif dans un format CPS ... Si vous avez la super solution idée du siècle, je suis preneur.
    => JENKINS-19118

24 juillet 2013

BreizhJUG Coding Challenge

Les plages de sable fin, le soleil étincelant, la mer turquoise ... quoi de plus banal après tout, et l'ennui risque vite de vous submerger cette été. Heureusement, il y a le grand concours de développement du BreizhJug !

Fort des 9h de conférences consacrées au web html5 / javascript que vous avez toutes suivies pendant le dernier BreizhCamp, il ne vous manque qu'un prétexte pour vous y mettre ? C'est le moment !


Le site www.breizhjug.org est une misère, aussi nous avons comme ambition d'en faire un nouveau, tout beau tout moderne tout chouette, et nous allons faire appel à vos talents.

Notre github propose un squelette d'application angularJS, ainsi qu'une liste de fonctionnalités à développer. Nous n'attendons plus que vos pull-requests ! Chaque item peut rapporter un certain nombre de points (indiqués dans le tracker). A noter que certains items sont indispensables pour démarrer quoi que ce soit, et donnent donc droit à un bonus pour vous encourager ;)

Qu'est ce qu'on gagne ?
  • notre reconnaissance !
  • une bonne bière à l'anniversaire du JUG pour le gagant
  • les noms de chaque contributeur sur le site, par ordre de mérite

Si vous voulez participer, ou simplement en discuter et/ou proposer de nouvelles fonctionnalités, rejoignez le google group du BreizhJUG


29 juin 2013

BreizhCamp 2013

Le BreizhCamp 2013 a été un événement magnifique, et je remercie chaleureusement l'équipe qui m'a accompagnée dans ce challenge et a relevé tous les défis, par ordre psuedo-aléatoire :

Nicolas LedezLaurent HuetGuillaume Collic, Yan BonnelSébastien BrousseMichel DavidHoracio GonzalezSylvain GuernionAlex ThomazoJulien Coste

ansi que Quang Hung et Jean-François Garreau qui nous ont accompagnés côté sponsors.

Le questionnaire que nous avons diffusé donne des résultats intéressants sur vos attentes :
Premier point, cette troisième édition vous a plu. C'est déjà un très bon point, mais nous ne sommes pas encore au 100% de satisfaction, aussi nous allons chercher à faire encore mieux.


Les nombreuses sessions "hands-on" de la première journée on été appréciées, et d'après vos retours il n'en faut pas nécessairement plus - ou en tout cas être rigoureux sur la sélection pour ne proposer que des sujets bien préparés.


La diversité des sujets a été appréciée, même si elle est encore améliorable. Sans surprise, le call for paper nous a amené essentiellement des sujets Java et HTML5/JavaScript, aucun sujet PHP, un seul sur Python, pas grand chose dans le monde Microsoft. Il faut que nous travaillions avec les communautés pour attirer ces speakers et démontrer l'intérêt de voir "ce qui se fait ailleurs".

... car vous jouez le jeu de sortir de votre zone de confort pour aller voir ce qui se passe dans le pré d'à côté, et c'est le but de la conférence donc j'en suis ravi.


Votre réaction fàce aux quelques sujets hardware est intéressante. Une moitié à globalement apprécié sans plus, un quart sont enthousiastes, l'autre quart n'en voient pas l'intérêt. Il y a donc clairement deux populations ici, une qui aime les talks où l'informatique rencontre le monde physique - dans 10 à 20 ans, le moindre objet sera connecté et communiquant - et une qui est sans doute plus pragmatique sur ses pratiques professionnelle et ne vois pas d'intérêt dans une raspberry pi autre que le côté gadget - je fais des applis de gestion, alors un minitel je ne vois pas bien l'intérêt.


Nos sponsors cette année ont été très présents, et leur implication pour animer la conférence a été appréciée. Tant mieux, car ils ne sont pas que nos financiers dans cette aventure, ils sont nos partenaires et il est important qu'ils prennent part à l'événement et que les participants y trouvent leur compte.


Notre buffet a été apprécié pour sa qualité, mais les quantités on posé problème. Avec les quickies sur la pause déjeuner, et l'enthousiasme des premiers arrivés à gouter à tout, certains on du se contenter d'un repas léger. Il est clair que nous corrigerons le tir sur les prochaines éditions.


L'absence de WiFi pour les participants, lié aux contraintes du campus universitaire, est de plus en plus contraignante pour vous. Malgré plusieurs mois de préparation, les solutions de replis mises en place dans deux salles pendant les hands-on n'ont couvert qu'une partie du besoin. Par ailleurs, nous devrons à l'avenir être vigilant pour les propositions de Hands-on, en insistant auprès de nos speakers pour expliciter les pré-requis dans la présentation de leur talk et toujours prévoir un "plan B" en cas de défaillance de l'infrastructure.

Enfin, 50% d'entre vous est prêt à revenir de manière inconditionnelle, 90% une fois le programme publié, voici des chiffres qui nous font honneur. 50% font d'ailleurs déjà du lobbying actif pour motiver leur collègues - si par la même occasion vous pensez pouvoir transmettre notre dossier de sponsoring 2014 contactez-nous - et si on considère que vous connaissez presque tous une personne qui n'a pas pu participer il semble évident que nous devons augmenter notre capacité d'accueil.


Quand à vos nombreuses suggestions ... laissez nous un peu de temps pour les éplucher :P

Merci en tout cas pour tous vos messages d'encouragement, et rendez-vous après l'été pour la rentrée du BreizhJUG, et l'inauguration du GDG-Rennes !


11 mai 2013

Scala, 7 semaines plus tard

Je viens de terminer le cours coursera sur scala, avec la satisfaction d'un 10/10 au dernier test - qui compense une grosse galère sur le précédent, que j'ai voulu faire à la cow-boy, regarder les vidéos m'aurait bien aidé, un peu comme si elles étaient faites pour ça, enfin bref.


Je ne sais pas si j'aurai beaucoup d'occasions de pratiquer - nous avons du Scala chez CloudBees, mais honnêtement je passe plus de temps dans le code de Jenkins ... ce qui est une autre affaire - cependant je voulais vous partager mes impressions :

les plus

  • L'inférence de type est impressionnante. On ne déclare jamais un type de variable, un cast ou que sais-je d'inutile. L'évolution "diamond operator" de Java 7 pour simplifier (sic) les génériques fait bien rigoler à côté. J'espère que le compilo Java sera un jour aussi puissant, cela réduit considérablement la pollution du code
  • Le plugin IntelliJ pour Scala est excellent. 
  • Le cours était autant sur l'approche fonctionnelle que sur le langage Scala, étant mon premier langage fonctionnel c'était donc très enrichissant. De mon point de vue c'est un excellent complément à l'impératif, et ça vaut vraiment le coup de s'y pencher. Ce que j'aime c'est que Scala autorise le mix des deux, on a donc le meilleur des deux mondes
  • On peut définir des abstractions vraiment puissantes, et encore j'effleure juste le potentiel de Scala, mais c'est plutôt plaisant.
  • J'ai apprécié dans le cours que pour présenter un traitement, Martin Odersky propose une syntaxe plus "compacte", plus "fonctionnelle", en précisant que c'est à chacun d'utiliser celle qui lui parle le plus. C'est important à mon avis de ne pas tomber dans le terrorisme fonctionnel qu'on reproche à certains développeurs scala.
  • Le plugin IntelliJ pour Scala est excellent. Sérieusement. J'ai fait les premières "semaines" avec vi mon MacBook étant en réparation, et le MacBook Air 2Gb trop léger pour supporter l'IDE. En même temps c'est formateur, mais retrouver un IDE super puissant aide énormément.

les moins

  • La syntaxe est parfois déroutante. Elle permet des expressions très compactes, mais du même coup potentiellement obscures. Pour des cas simples ça se justifie, mais on a vite fait de se prendre soi-même au pièges, et je ne parle même pas de bosser avec des scala(f)istes chevronnés. Plus que dans un autre langage amha il faut être très vigilant sur la structuration de son code
  • Il faut vraiment réfléchir à ce qu'on fait. C'est con, mais c'est fatigant. Développer un putain d'écran en struts, ça prend 3 jours mais y'a pas trop à se fatiguer la tête ;) Plus sérieusement, quand y'a un truc qui cloche on se creuse bien la tête pour démêler tout ça, il est donc important d'avoir une structuration très propre du code, avec méthodes bien ciblées et tests unitaires. Vous me direz, on fait déjà tous ça en Java, isn't it ?
  • Les OOME:PermGen de SBT, c'est tout de même la misère cet outil. Je me demande ce qu'il donne sur un "gros" projet.
  • J'ai vraiment eu du mal à me faire à la syntaxe des for {} yield. Au début j'ai préféré écrire les cas simples en Range.map() qui me semblaient plus clair. C'est sans doute une question d'habitude ?
ma conclusion

Très content d'avoir pu suivre ce cours, surtout qu'il est vraiment très bien fait (ne manquez pas le hands-on Scala au breizhcamp). J'ai appris une approche différente et apprécié certains aspects de Scala, qui me titillerons probablement dans du futur code Java, comme le fait déjà Groovy quand un peu de "dynamique" m'aiderait bien.


Scala est un bon langage, élégant (comme le montre la photo), puissant, très complet, souple (fonctionnel et impératif), mais je ne crois pas qu'il deviendra un langage mainstream : trop complexe et exigeant. Par contre, croire que Java 8  apportera un équivalent "fonctionnel" avec les lambdas est une vision bien simpliste des choses, cela permettra des choses mais ce sera le fonctionnel du pauvre. Surtout qu'apprendre Java 8 pour un junior aujourd'hui, avec les génériques, lambda, et 250 frameworks ce n'est pas un cadeau.

J'attends donc un (futur) langage, un Scala bridé mais plus accessible, un peu comme Java le fut à l'époque de C++.


29 avril 2013

Mix IT

J'étais la semaine dernière à Lyon pour Mix-IT, conférence que je ne connaissais pas encore. Et bien je suis jaloux par rapport au BreizhCamp :


  • les speakers sont choyés, avec pré-réservation d'hotel et speaker dinner d'antologie
  • ils accueillent pas moins de 350 participants
  • les locaux sont superbes, prétés gracieusement par Supinfo - certes un peu loin du métro, mais avec ce qu'on s'est empiffrés la veille un peu de sport ne fait pas de mal
  • il fait beau au moins 50% du temps
  • ils reçoivent des speakers internationaux : Github, Travis, Cloudbees (ah non, c'est moi ça)
  • au commande, une équipe de choc - et encore, avec une femme sur le point d'accoucher ils étaient en effectif réduit. Les étudiants de Supinfo participent activement et ça c'est chouette
  • ils font une Mix-it Party le jeudi soir. C'est sur qu'après la débauche du speaker dinner il fallait bien ça pour se remettre. Je me suis retrouvé à coder g# ... 
  • ils ont un super logo :P
  • ça donne envie d'y retourner


Bon, je ne suis pas si jaloux que ça, parce que le Breizhcamp va être bien aussi

  • les speakers seront choyés, avec un speaker dinner encore bien plus mégafestif
  • on aura facile 10000 participants
  • nos locaux sont grandioses, et encore ce n'est rien par rapport avec ceux qu'on trouvera pour l'édition 2014
  • les 13 et 14 juins, ils fera beau à 200%
  • nous aurons nos premiers speakers internationaux !
  • au commande, on a pas de femme enceinte (au dernières nouvelles) mais on est tout de même toute une équipe. Je ne désespère pas de voir quelques étudiants cette année
  • nous ferons une Breizh-Party jeudi soir en même temps que le speaker-dinner, en gros ceux qui voudrons nous rejoindre seront les bienvenus
  • nous avons un chouette nouveau logo
  • tous ceux qui sont venus ont envie de revenir
  • NOUS avons de super goodies, nananèreu
Blague à part, Mix-IT est une très chouette conférence, qui me donne plein d'idées pour améliorer le BreizhC@mp, c'est ça qui est chouette avec ces conférences qui se développent en France, on se passe des tuyaux et on peu tenter appliquer les bonnes idées vues ailleurs.

Donc si vous aimez le breizhcamp, le jugsummercamp, et même devoxx, essayer de caser deux jours pour faire un tour à Mix-it l'an prochain, ça vaut le détour

Bonne adresse

Mon gamin a explosé l'écran de mon MacBook. Ca énerve un peu sur le coup, et puis bon, on va le garder quand même (le gamin) et faire réparer la bête (le MacBook).

Là commence l'épopée...

A Rennes, nous n'avons pas (encore) d'Apple Store officiel, aussi je me suis tourné vers un revendeur officiel, DXM - plutôt qu'un service d'échange sur Internet, qui aurait fait emporter ma machine pas UPS pour me la rendre quelques jours plus tard d'après la pub, mais j'ai préféré la solution locale (erreur?)

Je dépose donc ma machine le 3 avril, machine qui est prise en charge sur un joli tapis de mousse pour ne pas risquer de rayer l'objet vénéré des apple fan-boys, mais bon vous fatiguez pas il est déjà tout rayé et l'écran est mort. Un devis doit être établis pour la réparation. Quand ? "on est déjà mercredi, ce ne sera pas avant la semaine prochaine" - ouhlà, on sent les cadences infernales !

6 jours plus tard, je demande des nouvelles, et on m'informe que le technicien a rencontrer des problèmes avec ma machine - j'aimerais bien en savoir plus, c'est pas que je sois de nature inquiète, mais cette annonce n'est guère encourageante sans plus d'informations.

Le lendemain, le technicien me contacte.
J'apprends que mon écran est pété (sans blagues ?), que le lecteur CD est bloqué et que la sortie vidéo est morte. S'en suit une discussion homérique avec le technicien certifié Apple ++ qui n'a donc pas constaté que j'ai remplacé le lecteur optique par un second disque dur - un rond par un carré, c'est vrai qu'il faut avoir l'oeil aguerri - et que la sortie vidéo fonctionnait quelques jours avant, comme peuvent en témoigner ceux qui m'ont vu à Devoxx pour la session "3615 Cloud". Je finis par blaguer en disans que ma machine ne supporte pas les écrans Apple et est habituée à son Dell, auquel elle est connectée chaque jour, pour couper court à ce débat délirant, et que le technicien accepte de m'établir le devis tant attendu - on est J + 8

J+9, pas de devis, je contacte donc mon revendeur premium, pour m'entendre dire que c'est la faute de gMail, qui met toujours leurs mails en spam - mais oui bien sur, c'est gMail, qui d'ailleurs n'a rien reçu même en spam. Je demande donc l'envoi sur ma boite @cloudbees.com (qui est aussi un gmail), et je reçois 5 minutes plus tard le devis pdf attaché à un mail vide - qui se fait classer en spam :-/ Il serait peut être temps de creuser la question de votre système de messagerie, pas simple de contacter vos clients dans ces conditions ... Au passage, mes deux mails adressés à @dxm.fr sont restés sans réponse.

Je renvois le devis signé le vendredi, et je rappelle pour m'assurer que la pièce est commandée, histoire de ne pas perdre en plus le week-end en attente

J+12, le technicien me contacte pour m'informer qu'Apple n'a pas d'écran haute-résolution en SAV et ne peut me fournir une date de disponibilité. Super, ça vaut le coup de passer par un revendeur premium ++.

J+22 : un SMS me prévient que ma machine est disponible. Dommage pour moi je suis déjà en route pour Mix-IT...

Ce lundi, je passe enfin récupérer mon MacBook, et là, surprise, ce n'est pas la dalle d'écran mais TOUS le capot supérieur qui a été changé, parti donc l'autocollant Dark-vador sur mesure que ma femme m'avait offert ! Et re-surprise, la pièce changée n'est pas sur place, elle a été envoyée à Apple pour "échange". Autrement dit, le super revendeur Apple premium ++ est juste un démonteur, qui n'a pas de pièce en stock.

J'ai demandé la récupération de la pièce d'origine, car je tiens à cet autocollant, mais je doute qu'elle soit retrouvée un jour, probablement déjà partie en recyclage (en supposant qu'un Mac, volontairement indémontable par conception, soit recyclable).

Bref, si vous avez besoin du SAV Apple, vous savez au moins où ne pas aller...


18 avril 2013

Call for Paper ...

Organiser une conférence, ça veut dire établir un programme, et pour cela la grande tendance c'est le "call for paper" : laisser les speakers venir à nous (en passant quelques petits mots incitatifs auprès des rocks stars).

Le breizhcamp a ainsi reçu 120 propositions, soit à peu près 2 fois le nombre de sessions. Le tri est donc assez facile comparé à une conférence comme Devoxx, avec 500 talks "conférence" pour 50 slots à pourvoir, et des notes du coup très serrées.

Car il y a aussi les notes : chaque membre du CfP vote pour les sujets en donnant une note de 1 à 5, selon des critères qui lui sont propres (speaker, sujet, ...) et sans connaître les notes de ses camarades. Il peut aussi bien sur ne pas voter pour les sujets sur lesquels il n'a pas d'avis, faute de connaître le domaine évoqué.

Pour gérer ces votes, nous (enfin, surtout Yan) avons développé une application pile poil pour gérer les votes, ce qui nous a permis de traiter le 120 sujets en quelques heures.

L'étape suivant c'est de dépouiller les résultats. Aussi nous nous sommes retrouvés pour appliquer l'algorithme suivant :


def selection( format: String, talks: List[talk] ) : List[talk] = 
        check(talks). // relecture des propositions
        sort( talk => talk.note ). // tri par note
        filter( talk => agree )


agree étant une fonction qui prend en paramètre l'équipe du CfP, passe par une étape de discussion récursive pour donner un résultat booléen.


L'idée est de remplir un tiers du programme en fonction des notes, puis de regarder dans ce qui reste ce qui est redondant, innovant, etc et qui mérite d'être sélectionné tout de même, ou bien de reclasser un sujet dans un autre format en fonction des informations que nous a fournis le speaker.


Nous arrivons ainsi au programme dont une version graphique sera publié dans quelques jours. Les speakers promus ont été notifiés, les autres devront se contenter de venir en spectateur.


Je sais la déception que peut être de ne pas être retenu à un CfP, la frustration d'avoir proposé un bon sujet qui n'est pourtant pas retenu, amis speakers ne nous en voulez pas, la tâche n'est pas facile et il faut bien trancher à un moment donné.